ChatGPT與Claude都有記憶功能,美國科技媒體《Every》的AI評測主管Mike Taylor卻全部關掉,每換一個任務就開新對話。
他在2026年10月17日的專欄解釋這麼做的原因是,對話內容愈積愈多,AI可能被舊指令、早期錯誤和無關細節拖累,回答品質跟著下滑,這就是「上下文腐爛」(context rot)。
上下文指的是AI在對話裡看得到的所有內容。Taylor把新書《Context Engineering with DSPy》整理的7種成因,改寫成一般人聊天時就能辨認的徵兆,並教你怎麼重開對話又不丟進度。
前面聊過的東西,會綁住後面的回答
1. 上下文干擾(context distraction):舊範例框住新答案
Taylor常在AI培訓課上示範:請ChatGPT用賈伯斯(Steve Jobs)的風格替新產品取名。只給文字指示時,21%的名字以「i」開頭(如iPod、iPhone);再附上幾個i開頭的範例,比例就變成100%。長對話也一樣,前面做過的東西都會變成AI照著走的範例。
徵兆:你要求換方向,AI的建議還是照舊範例的套路。
對策:任務的語氣或類型一變,就開新對話。
2. 上下文衝突(context clash):早期假設卡住新資訊
微軟(Microsoft)與Salesforce的研究人員在2025年做過實驗:把原本一次交代完的指令,拆成好幾則訊息分批給AI,模擬一般人邊聊邊補充的習慣。結果在寫程式、做摘要等6類任務中,受測模型的表現平均下滑39%。AI常在資訊還不完整時就先猜答案,這個答案會跟你後來補充的內容打架。
徵兆:你補充說明了,AI還是沿著先前的假設做。
對策:Taylor建議把需求一次講完,全部放進第一則訊息;中途發現漏了,就帶著完整需求開新對話。
3. 上下文中毒(context poisoning):一個錯誤污染後續回答
Google的Gemini 2.5技術報告就描述過這種現象:Gemini 2.5 Pro玩《精靈寶可夢 藍》時,誤以為要拿到只有重製版才有的道具「TEA」才能通過守衛,花了許多個小時找一個不存在的東西。聊天時,AI早期記錯一個事實,之後每版草稿也會照抄。
徵兆:已經更正過的錯誤,又出現在下一版。
對策:Taylor建議不要在同一個對話裡跟AI爭論,因為錯誤和你的抱怨都還留在紀錄裡。不如回頭編輯出錯之前的那則訊息,或重新生成回答。他打了個比方:AI看到紀錄裡有錯,會以為自己在演「一個會犯錯的AI」。
資訊塞太多,AI反而抓不到重點
4. 上下文混淆(context confusion):無關細節左右回答
AI不太會略過無關資訊,只要寫在指令裡,它就當成有用意、設法用上。Taylor的同事Katie Parrott把給AI的寫作風格指南,從759個英文單字加長到3,855個,結果文章糟到認不出來,一篇改了127版。最後的解法是刪指令,新版只剩513個單字。
徵兆:AI一直扯到跟問題無關的事實、偏好或框架。
對策:Taylor的做法是關閉記憶功能,自訂指令(custom instructions,每次對話自動帶入的設定)也愈精簡愈好。
5. 上下文忽略(context neglect):中間的細節被跳過
史丹佛大學等研究人員2023年的論文〈Lost in the Middle〉發現,受測模型最記得住開頭和結尾的內容,關鍵資訊如果夾在中間,表現就明顯變差。Taylor也做過實驗:給AI看9份專案文件,把關鍵的錯誤回報放在第6份,再問專案有什麼風險,AI完全沒提到它。
徵兆:其他文件都引用對了,偏偏漏掉夾在中間的關鍵細節。
對策:只上傳需要的文件,不同文件的問題分開在不同對話問;重要資訊放在訊息最前面。
6. 上下文漂移(context drift):原始目標逐漸失焦
對話拉長後,AI的回答仍然通順,卻慢慢不照你一開始的要求做。Taylor舉例,開頭要求寫程式的AI嚴格遵守Python的程式碼風格規範PEP-8,聊了50則訊息後,它已完全不理。日常使用也常見,要求回答在200個字以內,一小時後又變回原本的長度。
徵兆:AI開始忽略你先前交代的規則。
對策:把固定偏好(拼字、語氣、長度)存成文件,每次開新對話就貼在最前面。Taylor也提醒,對話太長時,Claude與Codex會自動壓縮前面的內容,細節和重要指令可能就此不見。
資訊給太少也不行:換對話前先做交接
7. 上下文不足(context underspecification):缺資訊逼AI用猜的
前6種都是資訊太多,太少同樣會出問題。缺了關鍵資訊,AI只能猜,Taylor形容猜出來的是訓練資料的「平均值」,也就是不考慮你處境的通用建議。他經營過50人規模的行銷代理商,知道「價值定價」(依客戶獲得的價值收費)對代理商常常行不通,AI卻一再推薦。
徵兆:回答套在誰身上都說得通。
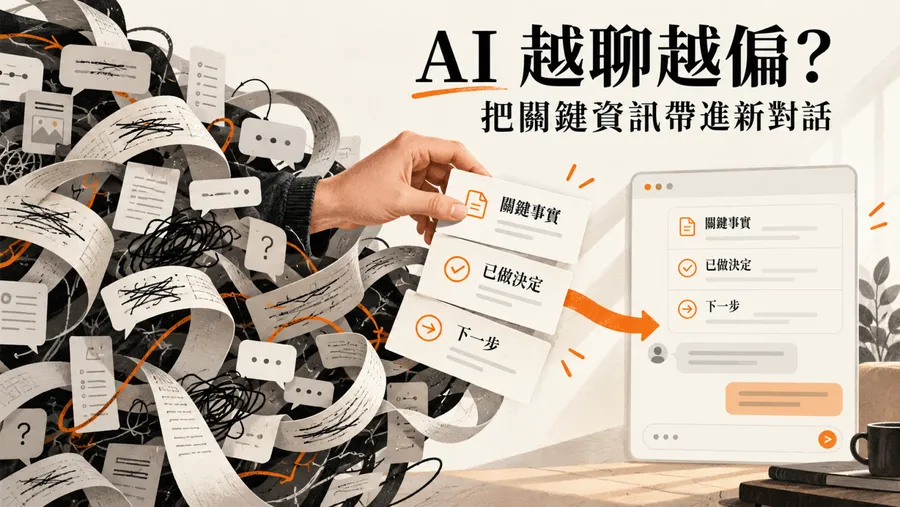
對策:長對話累積了有用的資訊、卻開始出現上述徵兆時,先請AI寫一份交接文件,整理重要事實、已做的決定和下一步,再帶進新對話。離開前也可以問AI:
這個任務一開始,有哪些資訊如果先知道,就能省掉好幾個步驟或避開錯誤?
把回答裡錯誤或過時的部分刪掉,再貼進新對話。
長期來看,Taylor把常用指令存成Markdown檔、放在GitHub上,讓AI需要時再讀,開新對話時直接拿來用。他在文末寫道,AI不會因為你重開15次而不耐煩,也不會提醒你對話已經一團亂,回答只會默默變差。每次都開新對話,他就能確定AI手上只有自己給的資料。
資料來源:《Every》、Lost in the Middle論文、LLMs Get Lost In Multi-Turn Conversation論文、Google Gemini 2.5技術報告
本文初稿為AI編撰,整理.編輯/ 李先泰