
談AI的歷史,需要談談很有名的AI寒冬。第一次AI寒冬是在1975年左右。1956年,在達特茅斯會議之後,包括很多國家政府,美國國家科學基金會、軍方,大家滿懷希望投了很多錢。但是到1975年以後發生了幾件事情,讓AI進入了寒冬。
1975年的第一次AI寒冬
第一件事是,因為AI只能解決Toy domain(擺弄玩具一樣的簡單任務)。那個時候做語音,只有10個詞彙;下象棋,大概是20個詞彙;做視覺的人,都不能辨認出一個椅子。
第二件事情,1956年美國打越戰,還有石油危機,所以經濟也不是那麼好;還有一個很有名的英國學者Lighthill,說AI就是在浪費錢,AI的研究經費也因此遭到大幅削減(註:在1973年出版的「人工智慧:一般性的考察」的報告,俗稱Lighthill報告中稱「迄今該領域沒有哪個部分做出的發現產生了像之前承諾的那樣的重要影響」。英國政府隨後停止了對三所大學Edinburgh, Sussex和Essex的AI研究資助)。
到1980年開始,有些公司如IBM開始做一些專家系統,可以說也是有限的應用。儘管有一些缺點,但還是可以做一些事情,據說有十個億的產出。因此,AI也就開始回春。我也是這個時候開始進入AI,所以也蠻幸運的。
我是80年代去美國CMU(卡內基梅隆大學)的。我記得當時日本很有錢,到處在美國買樓、建實驗室,所以當時日本提出了一個第五代電腦系統計畫(5th generation computer Systems,FGCS)。當時還有公司專門做 Lisp Machines(通過硬體支援為了有效運行Lisp程式語言而設計的通用電腦)。就有點像今天DNA紅,大家都在做DNA晶片,那時候大家都在做Lisp Machines,Thinking ( Connection ) Machines,然後神經網路也剛開始發芽。
1990年中,AI又第二次遇冷
不過,到1990年中,AI又第二次遇冷,為什麼會這樣?因為第五代計畫失敗,Lisp Machines和Thinking ( Connection ) Machines都做不出來;而神經網路,雖然有意思,但並沒有比其他一些統計的方法做得好,反而用的資源還更多,所以大家覺得也沒什麼希望了,於是AI又進入第二個冬天。
差不多在冬天這個時刻,統計的方法,使用資料的方法出現了。
AI在1990年以前都是用所謂的研究人腦的方式來做;而我們有太多理由來相信人腦不是靠大資料的。比如,給一個小孩子看狗和貓,看幾隻他就可以辨認了。可用今天的方法,要給電腦看幾十萬、幾百萬隻狗跟貓的圖片,它才能辨認是狗還是貓。
用大資料這種方法,就在第一次AI寒冬和第二次AI寒冬之間開始萌芽。雖然AI是一批電腦科學家搞出來的,但事實上有跟AI極其相關的一門叫模式識別。模式識別一直以來都有工程師在做,從1940年代統計學家就在做模式識別。
我們這代人學電腦就知道兩個人,一個人叫傅京孫(K. S. Fu),另外一個人叫竇祖烈(Julius T. Tou)。如果AI選出60個人的名人堂,裡面會有一個叫傅京孫,那是大牛。傅京孫嚴格上來講他不算AI,但是可以包括進來,因為他也做模式識別。
模式識別裡面也有兩派,一派叫統計模式識別(Statistical Pattern Recognition),一派叫做句法模式識別(Syntactic Pattern Recognition)。80年代的時候,句法是很紅的,統計人無人問津,後來1990年以後大家都用統計。
我們做語音的人很清楚,後來引入了隱瑪律可夫模型(Hidden Markov Model),都是統計的方法,到今天還是很有用。尤其是在華爾街,做金融投資,做股票,很多都是做時間序列(time series data),而隱瑪律可夫模型這個東西是很強大的。甚至可以說,統計的方法是我們做語音的人(發展起來的)。
而且早在1980年,我們做語音的人就講出這句話「There is no data like more data(沒有什麼樣的資料比得上更多的資料)」。從現在的角度來看,這是非常前瞻性的,而且就是大資料的概念。我們那個時代的資料量無法和現在相比,但我們已經看出來了資料的重要。而且IBM在這方面是了不起的,他們一個做語音的經理有次說,每次我們加一倍的資料,準確率就往上升;我們每炒掉一個語言學家,準確率也上去。
決策樹也是第一個被語音研究者所使用。然後就是貝葉斯網路(Bayesian Network),幾年前紅得不得了,當然現在都是用深度學習網路(deep neural network, DNN,在輸入和輸出之間有多個隱含層的人工神經網路)了。我為什麼要提這些東西?今天我覺得很多人上AI的課,可能75%、80%都會講DNN,其實AI還是有其它東西的。
今天要教AI也是非常困難的。我還特別看了一下最近的AI教科書,像吳恩達等人的。他們學術界教AI,還會教這些東西,但是如果去一般或者大多數公司,全部都是在講DNN。我覺得現在找不到一本好的AI教科書,因為早期的書統計沒有講,或者沒有講DNN。
我也看了下加州大學伯克利分校的Stuart J. Russell 跟Peter Norvig寫的教科書(Artificial Intelligence: A Modern Approach),裡面DNN提了一點。可能現在也不好寫AI,因為AI提了這麼多東西,人家說根本沒用,不像DNN的確很有用。
我稍微解釋一下DNN和一般統計方法的差別。統計的方法一定要有一個模型,但是模型一定是要有假設。而你的假設多半都是錯的,只能逼近這個模型。資料不夠的時候,一定要有一定的分佈。當資料夠了,DNN的好處是完全靠資料(就可以),當然也需要很大的計算量。所以DNN的確有它的優點。
以前我們用統計的方法做,還要做特徵提取,用很多方法相當於做了一個簡易的知識表示;現在用DNN連特徵提取都不用做了,只用原初資料進去就解決了。所以現在講AI不好講的原因是,DNN講少了也不對,講多了的話,說實在的,全是DNN也有問題。
神經網路的起伏
最早的神經網路叫感知器(Perceptron),跟第一個寒冬有關。因為一開始的感知器沒有隱含層(hidden layer),也沒有啟動函數(activation function),結果Marvin Minsky和Seymour Papert這兩位就寫了一本書《感知器》說,感知器連異或(XOR)都做不出來。那麼,做感知器還有什麼用?所以基本上就把整個神經網路第一代的進展扼殺了。
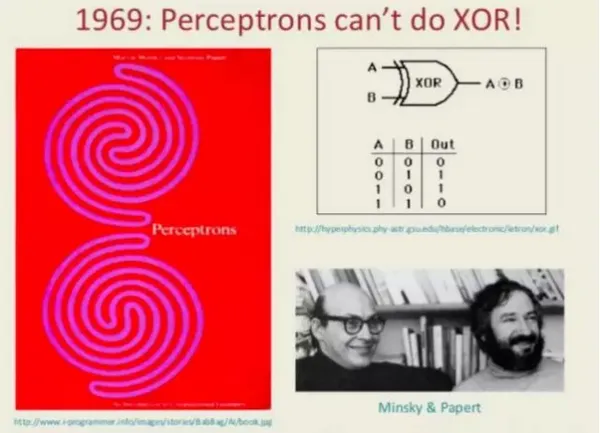
其實後來人們發現誤會了,其實書並沒有說的那麼強,不過的確造成了很大的影響。一直到1980年,做認知心理學的人,代表性的如Rumelhart和才復興了AI。
Geoffrey Hinton早期是做認知心理學的。Geoffrey Hinton先在UCSB(加利福尼亞大學聖巴巴拉分校),後來到了CMU。Rumelhart, Hinton and McClelland 復興了多層的感知器,加了隱含層以及back-propagation 演算法,這個時候神經網路就復興了。而且神經網路只要加上隱含層,事實上,只要加一層,再加上啟動函數,就可以類比,甚至還有人證明可以類比任意的函數,所以神經網路一下子就變的紅了。卷積神經網路(Convolutional NN,CNN)那時候就開始出來了,然後是遞迴神經網路(Recurrent neural network,RNN)。
因為如果要處理過往的歷史,有存儲, 就需要回溯。用於語音和自然語言處理的時間延遲的神經網路(Time-Delayed NN,TDNN) 也都有了。
不過,那時候資料不夠多。資料不夠多就很容易以偏概全。第二個因素是,計算的資源不夠,所以隱含層也加不了太多。這樣,神經網路雖然大家都很有興趣,也能夠解決問題,但是卻有更簡單的統計方法,如支持向量機(Support vector machine,SVM),能夠做到一樣或者略好。所以在1990年代就有了AI的第二次冬天,直到DNN的出現才又復甦。
AI的復甦
AI的復甦,可能要從1997年開始說起。1997年,深藍打敗了國際象棋冠軍Garry Kasparov。這裡我要提一下一個人叫許峰雄。他當時在CMU做一個當時叫做深思(deep thought)的項目,基本上架構都有了。結果,IBM非常聰明。他們到CMU參觀,看到許峰雄這個組。然後也沒花多少錢,最多兩百萬,就買下了這個組,讓這些人到IBM做事。IBM當時就看到,在五年之內就可以打敗世界冠軍,其實真正的貢獻都是在CMU做的。
許峰雄後來也離開了IBM,加入了我們,一直做到退休。AI復甦的實際上才剛開始。有人說這個也沒有幫助到AI復甦,因為深藍可以打敗國際象棋的冠軍,也不是演算法特別了不起,而是因為他們做了一個特殊晶片可以算得很快。當然,AlphGo也算得很快,算得很快永遠是非常重要的。
到了2011年,IBM做了一個問題回答機器叫華生(Watson),打敗了Jeopardy遊戲的冠軍。Jeopardy這個遊戲其實也很無聊,有一點像記憶的遊戲:問一個常識的問題,給四個選項。其實華生打敗人也沒什麼了不起的。
到2012年,AI的復甦就已非常明顯。機器學習和大資料採擷變成了主流,幾乎所有的研究都要用,雖然還不叫AI。事實上很長一段時間,包括我們做語音和圖像,對外都不講AI。因為AI這個名字那時變得有點名聲不好。人們一說起AI,就是不起作用。第二次AI寒冬的時候,只要聽說某個人是做AI,那就認為他做不成。其實機器學習是AI的一支。
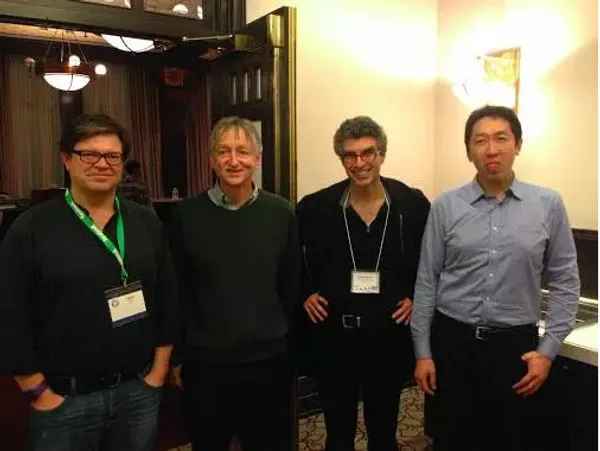
現在回到深度學習,有三個人物對深度學習做出了很大貢獻。第一位,Geoffrey Hinton。這個人非常了不起。了不起之處在於當沒有人在乎神經網路的時候,他還在孜孜不倦的做這個東西。第二個做CNN的人物是Yann LeCun。
他也是做CNN一輩子,在AI冬天的時候繼續做,所以今天很多CNN該怎麼用來自於Yann LeCun。另外一個叫做Yoshua Bengio。所以,現在還有人在排中國十大AI領軍人物,我覺得很搞笑。我覺得誰在外面講AI,或者搞個公司,他們和科學家是兩回事,科學家是在別人以為冬天的時候還在做。
所以今天講到DNN、講到AI,沒有前人的種樹,就沒有後人的乘涼。這61年的發展,這些辛苦耕耘的人,大家需要記住這些人。今天在檯面上講AI的人都是收成果實的人,講自己對AI有什麼貢獻,我覺得就太過了。
還有一個跟AI有關的,大家記得Xbox幾年前有一個叫Kinect,可以在玩遊戲的時候用這個東西,我覺得這是第一個發佈的主流的動作和語音感知設備。當然之後就有2011年蘋果的Siri,2012年Google語音辨識的產品,以及微軟2013年產品,這些都是AI的復甦。直到2016年,AlphaGo打敗了李世石,打敗了柯傑,AI就徹底復甦了。
今天的AI
DNN、DNN還是DNN。
我不是有意要貶低DNN的重要性,但如果說DNN代表了所有的智慧也言過其實。DNN絕對非常有用,比如機器視覺,會有CNN;自然語言或者語音的,就有RNN,長短時記憶(Long Short-Term Memory,LSTM)。電腦視覺裡面有一個圖片集imageNet。我們很榮幸在幾乎兩年前,微軟在該圖片集上辨認物體可以跟人做得一樣好,甚至超過人。
語音也是一樣,微軟在差不多一年前,在Switchboard,在任意的一個任務裡面也超過了人類。機器翻譯我相信大家都常用,可能是每天用。甚至看起來好像有創造性的東西也出現了,比如小冰可以寫詩。我也看到很多電腦畫出來的畫,電腦做出來的音樂,都表現的好像也有創造力一樣。
不過,雖然AI很紅,機器學習,大資料大家都聽過,特別是做學問的人還聽過大資料採擷,那麼這三者有多大的差別?我常說這三個東西不完全一樣,但是今天這三個的重複性可能超過90%。所以到底是AI紅,還是大資料紅呢?還是機器學習紅呢?我覺得有那麼重要嗎?
文章轉載自微信公眾號知識份子。
《數位時代》長期徵稿,針對時事科技議題,需要您的獨特觀點,歡迎各類專業人士來稿一起交流。投稿請寄edit@bnext.com.tw,文長至少800字,請附上個人100字內簡介,文章若採用將經編輯潤飾,如需改標會與您討論。
(觀點文章呈現多元意見,不代表《數位時代》的立場。)