

叫AI「幫我把這個改快一點」,就像叫人減肥卻不給他體重計,改了一堆,沒人說得出到底有沒有變好。
Anthropic在2026年9月23日公開的一篇工程文章,示範了另一種用法:先給AI一台體重計,再讓它自己想辦法把數字壓下去。
實驗對象是Anthropic自家的claude.ai網頁版與Claude桌面App。Anthropic表示,旗下團隊在2026年8月的兩周內合併超過3,000次程式修改,沒有發生任何一起影響用戶的事故,也沒有任何一次需要把已上線的修改退回;依真實用戶監測資料,團隊挑選的13項核心操作指標平均(幾何平均)快了3.1倍,但不代表每項操作都快3倍。最有感的例子是網頁版:從打開到可以打字,由3.1秒降到0.55秒。
文章共同作者之一、Anthropic工程師Raymond Wang在官方開發者部落格發表〈How we made claude.ai 3x faster in two weeks〉,公開整套做法。團隊把工作搬進一個Slack頻道,大量實作交給Claude Tag(Anthropic放進Slack的AI隊友功能,beta版):找出拖慢速度的地方、設計測試、提交修改、盯著每次上線;工程師負責定目標、做取捨、批准每一筆修改。
第1步:給AI一份職務說明
衝刺開始前,團隊在頻道裡給Claude一份常駐指令,內容像一份新人的職務說明:負責什麼、要主動做什麼、要跟誰回報。以下依原文改寫成中文範本,方括號處換成自己的產品:
@Claude 你的工作是負責[產品名稱]效能相關的一切事務。
你的職責包括:
1. 監控每次部署,找出效能退步
2. 評估現有監測數據是否準確、完整
3. 維護一份整理好的監控儀表板
4. 主動修正觀察到的問題與容易處理的改善點
5. 提出值得投入的效能專案
6. 隨時向人類隊友回報
這個頻道的最終目標,是讓你盡可能自主運作,但我們知道今天還做不到。
這份說明把AI的角色從「等人交辦」改成「對結果負責」。最後一句同時設下期待與邊界:方向是自主,但人還在迴圈裡。團隊接著列了約20個改善專案,請Claude估算每個專案能省下多少時間,據此訂出目標;結果第3天就達成13項目標裡的12項。
第2步:先找一把量得準的尺
體重計不準,減再多也看不出來。工程師Sam問Claude,除了秒數還能量什麼,Claude列出好幾種每次量都一樣的指標,例如程式執行的指令數、畫面重新繪製的次數。11分鐘後,5條討論串已經各自針對一種指標開工。
每把新尺都要先過一關:證明把它壓低,用戶真的會感覺變快;證明不了就撤掉,不讓AI在沒有意義的數字上白忙。可以這樣下:
請針對[要改善的流程],提出3到5種在測試環境可重複量測、結果穩定的指標(例如執行次數、重新渲染次數),不要只用實際秒數。
接著逐一證明:把這個指標壓低,是否真的能換到用戶感受得到的速度提升。
無法證明的指標,請直接列出並建議撤除。
第3步:讓AI自己試、自己看結果
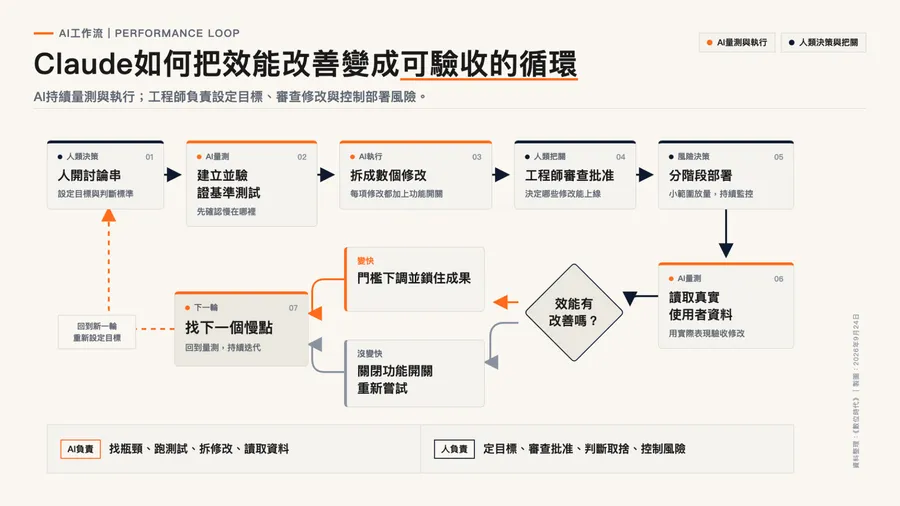
每條討論串都由人開頭,描述哪段操作很慢,通常附上截圖或錄影。接下來AI跑一個固定循環:先設計能重現問題的測試,修改後確認測試過關,送上線後看真實用戶的數據;變快了就把門檻往下調,沒變快就撤回重來,然後去找下一個慢的地方。工程團隊可以直接這樣下:
這條討論串只處理[某個流程的某一段]。請依序:
1. 追蹤這段流程,找出或建立能重現問題的基準測試
2. 在測試環境取得改善後,依風險拆成數個修改送審,用戶看得到的變動一律加功能開關
3. 部署後讀取真實用戶數據
4. 有改善就把基準門檻往下調並鎖住;沒改善就關掉開關、重新嘗試
5. 完成後,在同一個流程裡找下一個慢點,不要停
實例是側邊欄跳動。有人分享一段錄影:頁面載入後,側邊欄的對話列表會陸續彈出、位置亂跳。既有監控卻都沒抓到,因為業界常用來衡量畫面跳動的指標,每次只算出約0.008分,遠低於0.1的警戒線。
工程師Issac提議直接讀瀏覽器記錄的原始跳動資料,Claude據此設計新的監測方式,並寫了一個專抓跳動的自動測試:舊版跑20次全部失敗,修正版跑20次全部通過。上線後看真實數據,發現31%的網頁載入在已經能操作之後,畫面還在跳動,Claude再一批一批修掉主要原因。
循環能轉這麼快,前提是安全措施先裝好。每筆修改都經過自動審查,並至少由一名工程師批准;動手改之前先寫好檢查,確保原本的功能不會壞掉;用戶看得到的改動都裝上「功能開關」,出問題可以一鍵關掉。風險高的改動則像餐廳推新菜,先給員工試用,再開放給1%用戶,最後才全面上線。兩周內團隊建了近200個功能開關,衝刺結束前已清掉一半以上。
第4步:人負責推一把、拍板體驗、定方向
原文說得很白:這個循環很有生產力,但並不自主。人的工作分三塊。
推一把。 Claude預設謹慎,會把發現先記成待辦、估時程時留緩衝。有一次Claude說修改「這周會送出」,Raymond Wang回它:現在送,我馬上處理上線,「please be braver」(請更大膽一點)。Claude改口一小時內送出。目標達成後進度開始放慢,Sam逐條留言:目標不是終點。對應的指令可以這樣寫:
目標不是終點。能現在送出的修改就現在送出,不要只記成待辦;時程請給實際可行的最快估算,不要預留緩衝。還有哪些方向沒試過?大膽一點。
拍板體驗。 每條討論串都有一名工程師負責,只要是用戶看得到的改動,Claude就附上改前改後的截圖或錄影,由人拍板,例如表格該一格一格出現還是整列出現、載入時的灰色預留框該立刻出現還是等半秒。
定方向。 每條討論串刻意只盯一件事,由人決定先做哪裡、哪些討論串該合併、何時收手。一個900行的修改,只為每次送出訊息省2毫秒,被一句話打回:不值得為此多維護一套額外工具。
哪些情境最適合這套做法?
- 問題能變成穩定的數字,例如等待時間、錯誤率
- 團隊已有自動化測試,能把門檻設成只降不升
- 產品能用功能開關與分階段上線,出錯可以立刻關掉
這套方法有什麼前提與限制?
先看工具。團隊用的是Anthropic內部研究模型,原文形容「大致相當於Opus 5.5」,外部用戶拿到的模型不一定有同樣表現;Claude Tag在2026年6月23日以beta版上線,開放給Team與Enterprise方案,上線公告寫明搭配Opus 4.8。
再看組織,這群工程師有權限隨時批准、立刻上線,如果你的公司每筆修改要走好幾層簽核,速度會明顯打折。
數字也要保留。3.1倍是13項指標的平均值(幾何平均),計算方式是比較2026年8月13日與8月27日的第75百分位,白話說,在所有測量樣本中,約75%的等待時間不超過這個值。各項落差很大:桌面App從完全關閉到打開只快1.9倍,Claude Cowork雲端模式送出訊息則快了19倍。
《RuntimeWire》指出,這是公司自行公布的結果,文章沒有公開流量樣本與計算細節,也無法說明變快是否帶動留存或營收。Anthropic自己也承認還沒做完:體驗最慢的5%、其他使用流程與超長對話,都還有改善空間。
結語
先造一把尺,再讓AI去爬;先證明尺量得對,再把門檻鎖住;最後,人仍須決定往哪裡爬、爬到哪裡停,並負責審查修改與控制上線風險。如果你手上的問題也能變成一個數字,就能用同一套邏輯試試看。
資料來源:Anthropic工程部落格、Anthropic官方公告(Claude Tag)、《RuntimeWire》
本文初稿為AI編撰,整理.編輯/ 李先泰
