文章為《數位時代》獲授權轉載自編程派
美國科學家11日宣佈,他們去年9月首次探測到重力波。這一發現印證了物理學大師愛因斯坦100年前的預言。宣佈這一發現的,是鐳射干涉重力波天文臺(LIGO)的負責人。
這個機構誕生於上世紀90年代,進行重力波觀測已經有近30年。那麼觀測到的重力波資料的量應該很大,科學家如何對這些資料進行分析?有沒有用到Python程式設計語言?
答案是肯定的。筆者在Github上發現了一個專門用於分析重力波資料的Python套件:GWPY。據維護者介紹,GWPY的程式碼來自LIGO和另一個名叫Virgo的機構,維護者將這兩個機構科學家的Python程式碼整理,最終的產品就是GWPY這個使用者友好的Python套件。
在具體介紹GWPY之前,先給和筆者一樣不了解的人簡單科普一下重力波和LIGO的相關知識。
什麼是重力波?

上圖是兩個黑洞所產生的重力波的3-D模擬圖(NASA)。
首先,什麼是重力波?在物理學上,重力波是愛因斯坦廣義相對論所預言的一種以光速傳播的時空波動,如同石頭丟進水裡產生的波紋一樣,重力波被視為宇宙中的「時空漣漪」。
通常重力波的產生非常困難,地球圍繞太陽以每秒30千米的速度前進,發出的重力波功率僅為200瓦,還不如家用電飯煲功率大。宇宙中大品質天體的加速、碰撞和合併等事件才可以形成強大的重力波,但能產生這種較強重力波的波源距離地球都十分遙遠,傳播到地球時變得非常微弱。
下面分享兩個優秀的影片,很好地解釋了重力波及背後的原理。第一個來自LIGO,第二個則是比較通俗的漫畫式講解。
###LIGO科學家的解釋:
http://v.qq.com/boke/page/g/0/0/g0184mxwie0.html
###漫畫式通俗解釋:
http://v.qq.com/page/j/x/u/j0184qlilxu.html
LIGO是什麼?
鐳射干涉重力波觀測站( Laser Interferometer Gravitational-Wave Observatory)LIGO是加州理工學院(Caltech)和麻省理工學院(MIT)的合作實驗室,現在也有其他的大學參與。實驗資金來源於美國國家科學基金會。LIGO是用來尋找宇宙中的重力波,從而可以驗證黑洞的存在和檢驗廣義相對論。

LIGO主要有兩個觀測點,位於路易斯安那Livingston Parish的LIGO Livingston觀測點,和華盛頓 Hanford的LIGO Hanford觀測點。除此之外,在加州Passadena 的Caltech校園中還有LIGO 40m Prototype 。
LIGO是如何探測重力波的?
GWPY:LIGO用它分析重力波資料?
接下來是本文的重頭戲。我們一起來學習如何GWPY分析重力波資料。下面的介紹及示例均來自GWPY的官方文件。
安裝
很簡單,pip install gwpy就可以完成安裝。
不過安裝的過程可能會比較長,因為gwpy使用的依賴套件比較多,套件括numpy、 scipy、 cycler、matplotlib、astropy等。
物件導向程式設計
GWPY是一個物件導向程式設計的Python套件,也就是說,資料物件是這個套件的核心關注點。每一個資料物件都體現為一個類實例,套件含了其屬性和套件含的資料。
如果想創建一個新的類實例,建議使用標準的構建器(constructor)。舉個例子,我們可以使用一個資料陣列,生成一個TimeSeries物件:
from gwpy.timeseries import TimeSeries
mydata = TimeSeries([1,2,3,4,5,6,7,8,9,10],sample_rate=1, epoch=0)
或者從線上資料伺服器上下載:
from gwpy.timeseries import TimeSeries
mydata = TimeSeries.fetch('H1:LDAS-STRAIN', 964656015, 964656615)
核心資料物件
據介紹,GWPY提供了4種核心資料物件,分別代表重力波探測器所產生的四種標準資料:
• TimeSeries(時間序列資料)
• Spectrum(光譜數據)
• Spectrogram(光譜圖)
• DataQualityFlag
重力波數據視覺化
我們知道,將重力波探測器收集的資料視覺化,對於理解重力波的特性、研究重力波信號來說非常有説明。gwpy.plotter模組中提供了一些plot類,可以直觀地展示相應的資料類型。
GWPY的核心資料物件裡,大部分都內置有一個plot()方法,可以讓研究人員快速對某個資料集進行視覺化展示。舉個例子:
from gwpy.timeseries import TimeSeries
data = TimeSeries.fetch('H1:LDAS-STRAIN', 968654552, 968654562)
plot = data.plot()
plot.show()
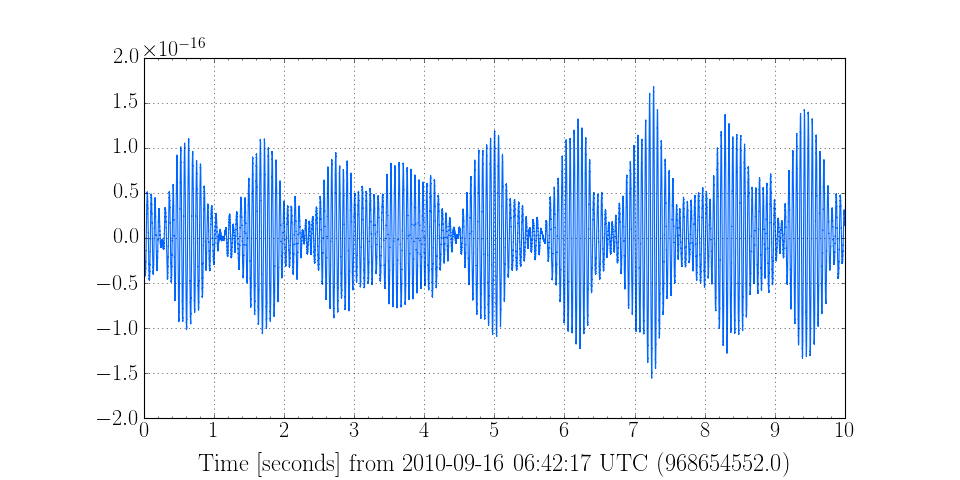
GWPY:利用公開的LIGO資料進行繪圖
我們接下來利用LIGO公開的一些重力波時間序列資料進行繪圖。我們可以直接線上載入這些資料。首先導入我們需要的模組:
from urllib2 import urlopen
from numpy import asarray
from gwpy.timeseries import TimeSeries
然後,下載資料,保存為文本字串:
data = urlopen('http://www.ligo.org/science/GW100916/L-strain_hp30-968654552-10.txt').read()
現在,我們可以對文本進行解析,補充必要的中繼資料之後,就可以生成一個TimeSeries:
ts = TimeSeries(asarray(data.splitlines(), dtype=float),
                 epoch=968654552, sample_rate=16384, unit='strain')
最後,我們就可以繪圖了:
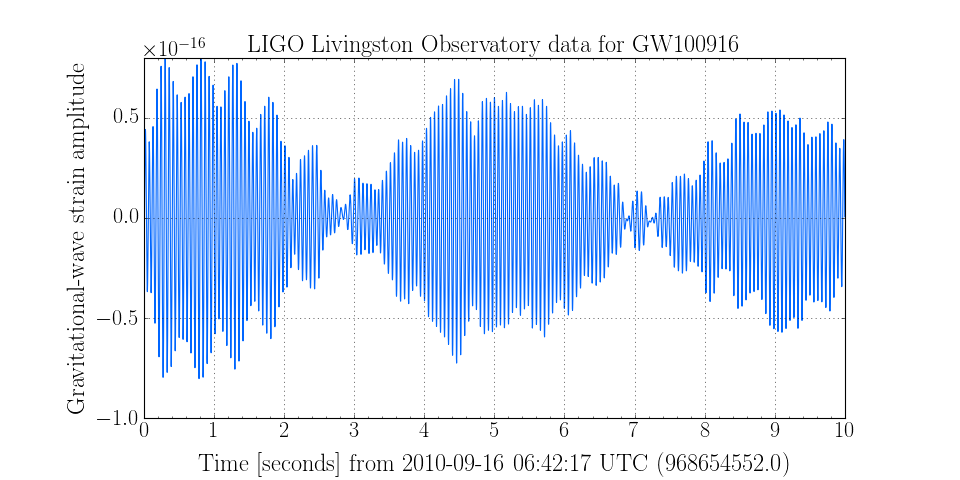
plot = ts.plot()
plot.set_title('LIGO Livingston Observatory data for GW100916')
plot.set_ylabel('Gravitational-wave strain amplitude')
plot.show()