別濫裝Claude Skill!Anthropic 新生態顛覆 SaaS:頂尖工程師為何只養 20 個黃金技能?

重點一:技能不是提示詞,而是三層結構的 SOP 系統,摘要、流程、知識庫必須分開管理,才能逐步調校。

重點二:技能描述模糊時,Claude 正確啟動率只有約 20%;裝 500 個劣質技能,比養 20 個精良技能更傷效率。

重點三:AI 技能是「人類流程的放大器」,SOP 若寫得含糊,AI 只會更快複製混亂。

隨著 Claude 訂閱大爆發,目前公開可安裝的 Claude Code Skills,光是第三方索引站 skillsmpp,就號稱從 GitHub 上抓了超過 28 萬個技能。另一個市集 skillhub 也收錄了上萬個技能。

於是網路上開始出現各種「炫耀清單」:一次裝載 500 個、甚至 1,000 個技能,彷彿數字越大,AI 就越強。

YouTube 頻道 Simon Scrapes 近期一支影片,直接用實測數字打臉了這個迷思。

據 Simon Scrapes 引用的一項非公開實驗,當 Claude Code 技能只有「基礎設定+模糊描述」時,模型能正確啟動對應技能的機率最低僅約 20%,等於是同一個任務連續嘗試五次,平均只有一次會真正叫對工具。

相反地,在技能描述明確、觸發條件與 hooks 設計完整的情況下,啟動率最高可提升到約 84%,但仍代表平均每五次互動就會有一次沒有成功啟動目標技能。

值得注意的是,這組數字是在僅包含四到五個精心設計技能的實驗環境下得到的;當實際部署的技能數量暴增到數百甚至上千個,而且描述彼此重疊、職能範圍模糊時,啟動失誤與「啟動錯技能」的風險只會進一步放大。

那問題到底出在哪裡?為何在網路上搜刮過來安裝的Skills,未必能幫到你?

技能不是「好一點的提示詞」

先從觀念回答起:多數人對技能的直覺是:一段更長、更精緻的 system prompt。 這個理解從根本上就偏了。

Simon Scrapes強調,真正能穩定運作的技能,是有三層結構的資料夾系統。第一層是 YAML 頭部:只有幾行,定義技能的名稱與觸發條件,決定 Claude 在掃描清單時會不會想到要用它。

第二層是 skill.md 的流程正文:告訴 Claude 啟動後按什麼順序執行,哪個節點需要停下來確認,遇到模糊輸入時怎麼追問;而第三層才是知識本體:references(細節知識庫)、assets(樣板格式)、scripts(可被呼叫的程式碼)。

這三層分開,帶來一個關鍵好處:出問題時,你知道要查哪裡。是流程描述不夠清楚?還是知識庫內容過時了?還是觸發條件寫得太模糊?三者拆開管理,才能逐步改良。

延伸閱讀:Agent skill 是什麼?Agent skill教學,6步驟打造你的第一個Skill

因此,把所有東西混在一個大提示詞裡,等同於把 SOP 手冊、操作說明書和程式碼,全部列印在同一張紙上,改起來無從下手。

這也是為什麼瞎裝一堆 skills,或是單純認為問題出在提問的 prompt,很難真正解決 AI 工作流的結構性問題。

漸進揭露:讓模型只看當下需要的東西

要先認知到的關鍵是,技能系統的核心設計原則叫做「漸進揭露」(progressive disclosure)。

技能清單的 YAML 頭部加總有一個 15,000 字元的上限。每次執行任務時,Claude 先掃描這份摘要清單,判斷需要啟動哪個技能;確定後,才把對應技能的流程正文載入上下文;流程中若需要查某份 reference 資料,再把那份文件讀進來。

Anthropic 官方把這個邏輯稱為「point, don't dump」:流程的作用,是在正確時機指向對的知識區塊,而不是一開始就把所有東西倒進去。

數據說明了差異。根據 Anthropic 官方指南的對比數據,同一個任務沒有技能時需要 15 輪往返對話、消耗約 12,000 個 tokens;有技能後減少到 2 個確認問題、6,000 個 tokens,執行成本減半,輸出穩定性同步提升。

更重要的是,這個架構讓技能可以組合使用。一個工作流程可以依序觸發**「文件解析技能」→「資料整理技能」→「報表輸出技能」**,每個技能只在需要時載入,不互相干擾。這比把所有流程塞進一個大提示詞要靈活得多。

真正值得用的技能是哪些?

技能生態的規模成長非常快,但訊號雜訊比很差。Indie Hackers 上有一位測試者花數個月評估了約 200 個技能,最後只推薦 20 個。他的篩選標準很具體:

  1. 第一次使用時輸出有沒有明顯超越不用技能的結果?
  2. 使用兩週後有沒有繼續用?
  3. 遇到邊界情況時會不會直接失效?

結果發現,按照上述**三個條件,大多數技能全數落榜。

當前Skills市集上重疊的情況十分嚴重。光是「SEO 寫稿」相關的技能,就有各種命名變體:SEO writer、long-form blog writer、content optimizer……。描述高度相似、觸發條件互相踩踏。把這些一次裝進來,Claude 在每次執行時都要從模糊的清單裡做選擇,選錯的機率自然升高。

反過來,養好 20 到 30 個針對自己工作流程設計的技能,讓每個技能的 YAML 描述清晰、觸發條件互不重疊,穩定啟動率可以維持在 80% 以上。這就是Skill「少而精」帶來的實際結果。

流程先於工具

技能系統最核心的現實,可以總結成依一句話:AI 是放大器,不是修復器。

一個能穩定產出的技能,背後必須先有寫清楚的 SOP、整理過的知識庫、以及對「什麼叫做完成」的明確定義。這些東西不是 AI 會幫你補上的,它們必須由人寫出來。如果一開始流程就含糊,技能只會讓混亂跑得更快。

對剛嘗試導入AI的工作者來說,有一個值得正視的慣性:習慣嘗試新工具、安裝新平台,卻很少停下來問「我們自己的流程是什麼」。

而技能系統恰好把這個問題強制搬上檯面,你必須先能說清楚自己怎麼做事,才能把它轉化成可重複呼叫的模組。

上萬個公開技能裡,真正值得用的可能不超過幾十個。但那幾十個養好了,會比 500 個裝好看的技能,更接近「組織知識的軟體化」。

延伸閱讀:Google AI生態系一圖看懂!從底層模型、寫Code到代理⋯6大領域20項產品全都包!

資料來源:Simon Scrapes

本文初稿為AI編撰,整理.編輯/ 李先泰
往下滑看下一篇文章
從台灣走進北美千家速食門市!Berry AI 如何攜手博弘雲端,讓 AI 規模化落地?

一家來自台灣的 AI 新創,如何讓美國上千家速食餐廳,都用它的 AI「看」得來速車道?

這家公司就是專注於 AI 影像辨識技術的 Berry AI (華捷智能),透過攝影機蒐集匿名數據並轉化為多項營運指標,協助速食品牌找出流程瓶頸、提升現場營運效率與整體顧客滿意度。以美國連鎖炸雞品牌 Zaxby’s 為例,在全面導入 Berry AI 解決方案後,服務速度提升 13%-20%,業績表現最好與最差的門市,每週營收差距從 2.4 萬美元縮小至約 9,000 美元。另一家連鎖速食品牌 Culver’s 在導入後,得來速車道的服務時間也立刻改善,進而提升整體吞吐量。

然而,支撐 Berry AI 解決方案的,不只有前端看得見的攝影機與影像辨識技術,還有後端穩定且具彈性的雲端平台。Berry AI 結合 Amazon Web Services (AWS) 全球雲端資源及博弘雲端顧問服務,打造兼顧即時性、穩定性與成本效益的雲地混合架構,成為推動 Berry AI 持續擴大北美市場版圖的重要關鍵。

從台灣 PoC 走向北美千店規模,Berry AI 面臨架構升級新挑戰

Berry AI 執行長林逸中表示,團隊成立初期投入近2年半的時間,探索最適合影像辨識技術的應用場景,最終將目光鎖定高度標準化的速食餐飲業(Quick Service Restaurant;QSR),推出得來速計時器、餐廳計數器等解決方案,運用 AI 影像分析技術,辨識顧客進入得來速車道或餐廳後的狀態,例如:排隊、點餐、候餐等。

同時,Berry AI 也進一步將現場蒐集到的數據轉化為可量化的營運指標,例如:不同門市、日期或時段的顧客等候時間,協助管理者從數據中找出流程瓶頸與可以優化的環節,進而提升服務效率及顧客滿意度。

在確立發展方向並於台灣完成 PoC (概念驗證)後,Berry AI 決定前進全球最大、也是 QSR 最核心的北美市場。然而,隨著合作客戶與部署門市持續增加,資料量快速攀升,加上服務範圍橫跨不同區域,既有以地端為主的架構開始面臨規模化挑戰。

林逸中補充指出,尤其 QSR 業者在選擇 AI 解決方案時,格外重視技術效能與穩定性,包括 AI 辨識精準度、能否因應突發狀況、系統能否穩定運作,以及網路發生問題時能否維持服務等。在這樣的要求下,若將所有運算與資料都留在地端,不僅難以因應日益增加的部署門市與資料量體,設備建置與維運成本也會隨之增加。

BerryAI 攜手博弘雲端 打造高可用性 AWS 雲地混合架構,突破北美規模化部署挑戰

如何確保系統的即時性、穩定性與成本效益,成為 Berry AI 進軍北美後必須解決的新課題。為此,Berry AI 選擇與博弘雲端合作,取得穩定且高可用的 AWS 運算與資料庫服務架構,將即時運算留在地端,同時在雲端環境整合資料庫處理大量資料與後續分析工作,形成兼顧地端即時運算與雲端彈性擴充的雲地混合架構。

Berry AI研發同仁汪楚剛說明,包括車輛偵測、追蹤與狀態辨識等需要即時反應的工作,會先在地端完成;再將辨識結果傳送至 AWS 雲端,計算各項營運指標,提供後續分析與決策使用。透過這套架構,Berry AI 至今已處理超過 2 億筆車輛狀態資料。

此外,AWS 也是 Berry AI 持續優化 AI 模型的重要基礎。Berry AI 將整套資料蒐集流程建構於 AWS 上,透過完整且多樣化的資料,持續訓練與優化模型,進一步提升地端影像辨識的準確度。

博弘雲端
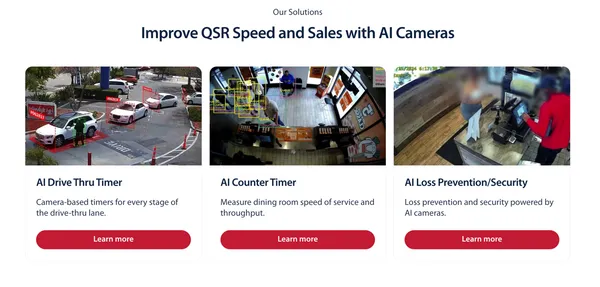
Berry AI 鎖定高度標準化的速食餐飲業(Quick Service Restaurant;QSR),推出得來速計時器、餐廳計數器等解決方案,運用 AI 影像分析技術,辨識顧客進入得來速車道或餐廳後的狀態,例如:排隊、點餐、候餐等,協助管理者從數據中找出流程瓶頸與可以優化的環節,進而提升服務效率及顧客滿意度。
圖/ Berry AI網站圖

成為企業技術團隊的延伸,博弘雲端助 BerryAI 把 AWS 用得更好、更省

隨著北美業務持續成長,Berry AI 也迎來新的課題:如何把雲端資源用得更有效率、更省成本,這也成為 Berry AI 與博弘雲端合作的重要契機。

對此,可能有很多人好奇,像 Berry AI 這類技術能力成熟、具備自行建置架構能力的企業,為什麼還需要與博弘雲端合作?「關鍵在於,博弘雲端長期深耕 AWS,對相關服務與技術架構更加熟悉,可以成為企業內部技術團隊的延伸。」博弘雲端技術長宋青雲說。

當 Berry AI 遇到特定 AWS 服務或技術問題時,可以直接尋求博弘雲端協助;若需要進一步與 AWS 原廠確認,博弘雲端也能協助溝通與處理,減少 Berry AI 自行研究與排除問題所需投入的時間,讓內部研發團隊可以將更多心力和資源集中在核心產品開發。

更重要的是,博弘雲端不只提供技術支援,還能從 Berry AI 實際用量與成長需求出發,客製化設計最適合的節費方案,這對 Berry AI 降低營運成本有很大的幫助。宋青雲說明,博弘雲端根據 Berry AI 既有的 AWS 用量,推估未來 1-3 年內的使用需求,並以此為基礎規劃合適的長期雲端資源用量;同時考量 Berry AI 所屬飛捷集團旗下還有 3 家子公司同樣使用 AWS,進一步整合集團需求進行評估,放大整體採購規模,爭取更大的節費空間。

宋青雲強調,雲端採取隨需即付的計價模式,雖然具備彈性優勢,但若缺乏持續管理,仍可能出現資源配置不符商務規劃,或費用超出預期等情況。而博弘雲端不只能從使用現況出發、建議適合的節費方案,也會從效能、資安與成本等面向進行架構健檢,提出相應的優化建議;同時還會提供相關管理介面,讓企業隨時查看帳戶使用狀況、預估未來用量,在業務規模持續成長的同時,也能兼顧雲端架構的效能、安全與成本效益。

而架構健檢與成本優化,只是博弘雲端服務的一環。從企業準備上雲開始,博弘雲端便能協助將應用程式與資料從地端搬遷至雲端,或直接在雲端完成部署;進一步還能協助建置數據平台、數據中台,進行資料分析及導入 AI 應用,讓企業資料發揮更大價值。當服務正式上線後,博弘雲端也能接續提供維運服務。換言之,從前期 PoC、雲端建置到後續維運,博弘雲端都能依據企業需求,提供相應的服務與支援。

對 Berry AI 來說,藉由與博弘雲端合作,深化 AWS 雲端資源使用,不只是突破規模化挑戰,更重要的是能把有限的資源集中在核心業務,持續優化解決方案、開發更多貼近餐飲營運需求的應用,進一步爭取更多品牌合作,擴大北美市場版圖。目前,Berry AI 正全力拓展北美市場,也持續尋找對 AI 技術與餐飲產業應用充滿好奇心、重視團隊協作的人才加入。徵才方向涵蓋機器學習與電腦視覺、Platform & System(DevOps、Infrastructure),以及 Full Stack 軟體開發。從門市邊緣裝置上運行的 AI 模型、串連雲端與數千家門市的系統平台,到協助餐飲品牌提升營運效率的分析產品,每個環節都還有發揮的空間。 期待匯聚更多優秀夥伴,一起用 AI 解決真實的營運問題,讓來自台灣的技術走進更多全球 QSR 門市。

職缺詳情:https://www.cake.me/companies/berryai/jobs

登入數位時代會員

開啟專屬自己的主題內容,

每日推播重點文章

閱讀會員專屬文章

請先登入數位時代會員

看更多獨享內容

請先登入數位時代會員

開啟收藏文章功能,

請先登入數位時代會員

開啟訂閱文章分類功能,

請先登入數位時代會員

我還不是會員, 註冊去!
追蹤我們
一次搞懂工業AI
© 2026 Business Next Media Corp. All Rights Reserved. 本網站內容未經允許,不得轉載。
106 台北市大安區光復南路102號9樓