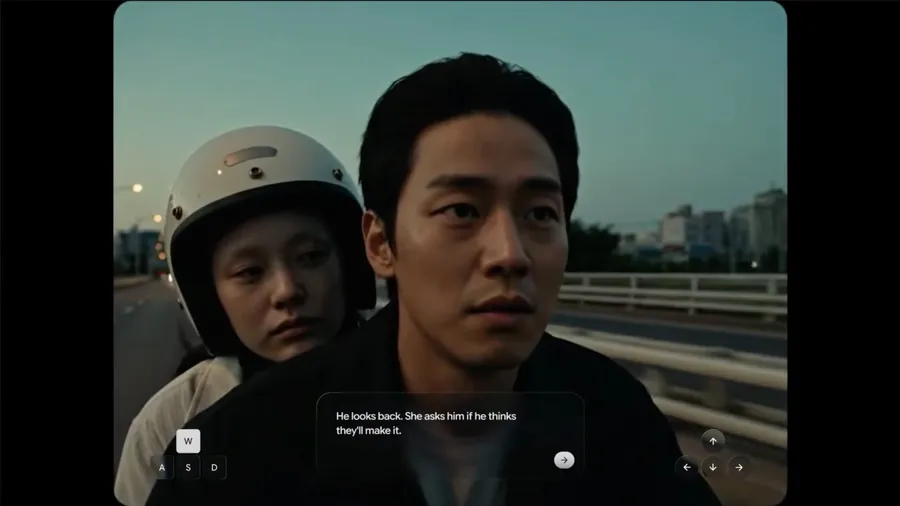
Google DeepMind於2026年10月27日(美國時間)發表新一代世界模型(world model)Genie 4,輸入文字描述就能即時生成可互動、可用鍵盤操控的虛擬世界。
這是DeepMind旗下首款原生生成音訊的即時世界模型,角色能開口對話,物理與人物動作更擬真,並由Gemini擔任「導演」維持連貫。
Genie 4以研究預覽形式僅開放受信任測試者,下一步才會開放給Google AI Ultra訂閱用戶與Gemini API、AI Studio早期夥伴,截至10月28日官方未公布時程。
Genie 4怎麼玩?物理、人物與聲音全面升級
Genie 4不需要使用者預先製作場景或逐一編寫互動元素,而是隨操作即時生成畫面:使用者描述場景,用鍵盤移動、控制鏡頭,再用文字提示調整劇情。
Genie 4的升級有三塊。物理上,DeepMind稱模型能模擬空氣動力、碰撞等情境。人物上,官方稱這是「最戲劇性的躍進」,角色動作更自然、會對環境反應。聲音上,每個世界帶著自身場景的環境音,從林間風聲到海浪拍岸;更關鍵的是人聲,角色會開口對話,並隨使用者輸入或世界裡的事件即時應變。
Gemini當導演:即時改劇本、拆解任務、模擬機器人
使用者可用自然語言即時改天氣、移動鏡頭、加入人物或物件,Gemini會依場景脈絡調整提示。背後是Gemini 3.8 Flash全程在旁監場(官方稱為guiding agent):持續觀察場景、把目標拆成步驟,並檢視生成中的畫面,追蹤任務進度並確認步驟是否完成;世界改變或使用者介入時,當場調整計畫。
DeepMind也試驗讓Gemini 4 Argon搭配Genie 4,把使用者指定的任務拆成步驟,模擬Apptronik的Apollo人形機器人下西洋跳棋,等於讓AI系統先在虛擬世界預演,再走進真實世界。官方把這種分工視為「混合式世界模型」的起點。簡言之,Gemini負責想劇本與推理,Genie負責把畫面與聲音即時生出來。
誰先用得到?測試者怎麼用、還有哪些限制
受信任測試者涵蓋創意、新聞、教育、遊戲與工程領域。官方列舉的用法包括:影視團隊當作預視草稿,即時跑多個「鏡次」;攝影記者探索把一張老照片變成可走入的場景;遊戲開發者在寫引擎程式前先做出可探索的原型;企業夥伴評估用它快速生成情境模擬。
限制方面,DeepMind坦言畫面細節與物件恆存性(物件離開視野後再出現,仍能維持存在與一致性)會隨時間漂移,複雜物理互動、即時音訊準確度、文字算繪、空間準確度與長時間一致性仍在研究中。
《Ars Technica》指出,Genie 4的世界只能維持連貫數分鐘,Gemini API定價也尚未公布。所有影像與聲音都會內嵌SynthID,這是Google用來辨識AI生成內容、一般人無法察覺的數位浮水印。
資料來源:Google DeepMind 官方部落格、《Ars Technica》
本文初稿為AI編撰,整理.編輯/ 李先泰