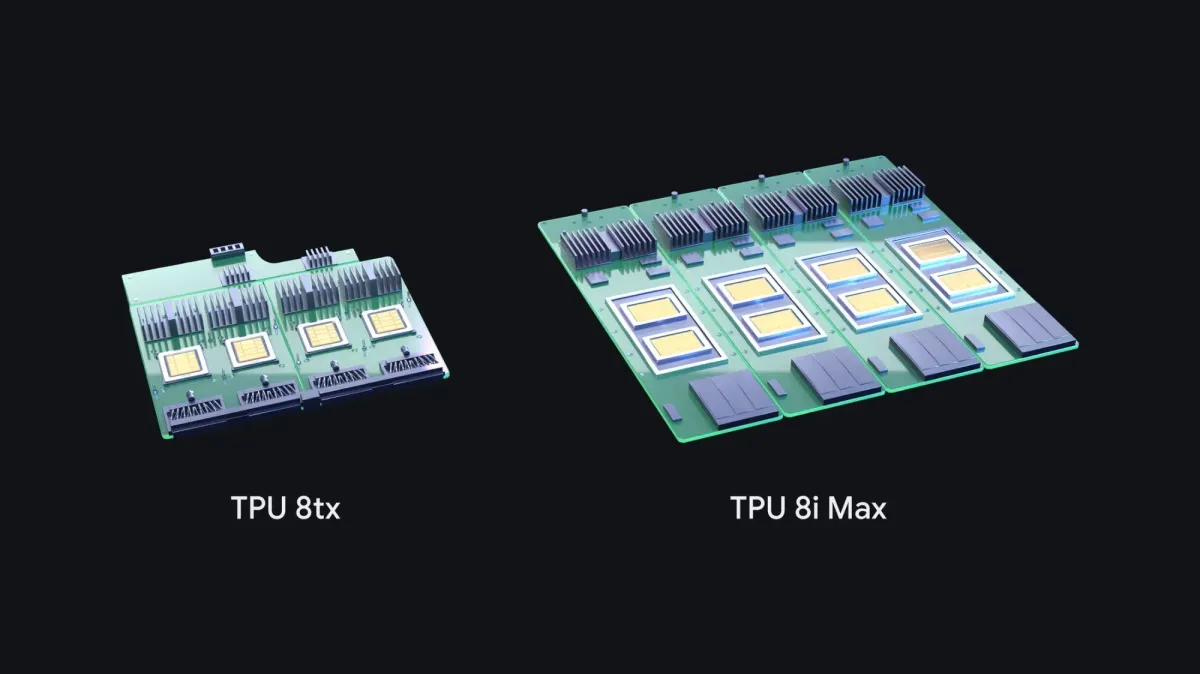
Google在美國時間11月9日擴充第八代TPU(Tensor Processing Unit,Google自研的AI專用晶片)產品線,新增主打機密運算的TPU 8tx,以及鎖定超長上下文(AI單次請求能納入考量的資料量)的TPU 8i Max。加上4月發表的TPU 8t與8i,這是Google首度在同一年內發表四款TPU系統。
兩款新品都瞄準AI代理人(能自行拆解並執行多步驟任務的AI)帶來的運算需求,母公司Alphabet股價當天盤中最多上漲4.1%,來到296.33美元。
兩款新系統各解決什麼問題?
TPU 8tx主打「機密運算」。資料平常在儲存或透過網路傳輸時會加密,但電腦處理時必須在記憶體中解開。8tx把防護直接做進硬體層,讓敏感資料與模型權重在運算過程中也受到保護與隔離,鎖定政府機關與受監管產業,在敏感資料旁執行前沿模型、自有模型與AI代理人。
8tx與訓練用的TPU 8t採用同一款晶片,搭配超微(AMD)第五代EPYC處理器,並沿用為即時推理打造的Boardfly低延遲網路,延遲比8t最多低一半,官方稱效能損耗趨近於零。企業可以在同一套系統內用私有資料微調模型、把大模型蒸餾成小模型,或用強化學習訓練代理人,敏感資料不必在不同叢集之間搬移。
TPU 8i Max要解決的則是「記憶體牆」,也就是晶片算得夠快,資料卻餵不上。當數十個AI代理人同時處理整個程式碼庫或長達數小時的影片,記憶體頻寬很快就成為瓶頸。
Google的做法是把兩顆TPU 8i封裝在一起,運算力、SRAM(晶片內建的高速記憶體),以及HBM(高頻寬記憶體)頻寬都是8i的兩倍;同樣的機櫃空間能放進兩倍的晶片,每平方英尺與每瓦電力能部署的算力大幅提高。
這兩款都不是全新晶片。Google晶片主管Amin Vahdat接受《彭博》專訪時表示,8tx與8i Max是依客戶需求重新配置的系統,預計2027年推出。官方部落格解釋,設計新晶片是長達數年的工程,系統則是調整晶片周邊的封裝、記憶體、網路與資安,幾個月內就能交付。
Google為何押注「專用化」?
「這確實符合我們在Google的論點:未來將是專用化的時代,而專用化帶來的好處依然相當可觀。」Vahdat在專訪中說。他認為,與其打造一顆試圖涵蓋整個市場的晶片,推出專用版本反而能創造更多價值。
TPU已是Google快速成長的生意,官方表示TPU已有近100家客戶,包括前沿AI實驗室、交易公司、零售商與大學。Bloomberg Intelligence預估,TPU銷售額(含相關軟硬體)2028年將突破1,350億美元(約合新台幣4.45兆元),遠高於2026年估計的120億美元(約合新台幣3,959億元),且還不含客戶透過Google Cloud使用的部分。
Bloomberg Intelligence分析師Mandeep Singh指出,TPU價格約比輝達(NVIDIA)GPU便宜30%,資料處理量卻具競爭力。
TPU的客戶還包括蘋果(Apple)與Meta;甲骨文(Oracle)10月宣布,2027年起讓雲端客戶首度能使用TPU。《彭博》引述近期的監管文件指出,Anthropic有權在2028至2031年間購買最多1,500億美元(約合新台幣4.95兆元)的TPU,與此同時OpenAI也計畫採購TPU。
其實就連輝達也開始走向專用化。過去主打GPU能包辦所有AI工作的輝達,如今也推出自家CPU來管理AI代理人,並運用從新創Groq取得的技術,推出更聚焦推論階段的晶片。
擋在前面的變數:缺貨與新對手
需求旺盛的另一面是缺貨。Google在10月財報中表示,手上每一顆可用的TPU都已被客戶簽走。記憶體與製造產能短缺,也讓Google難以滿足需求。
為此,Vahdat的團隊正設法分散供應來源。除了負責安排TPU製造的博通(Broadcom),Google近幾個月也與博通的對手邁威爾(Marvell)簽約,內容涵蓋部分TPU工作;另有報導指出聯發科(MediaTek)參與Google的TPU業務。
新對手也陸續出現。由兩名前TPU工程師共同創辦的新創Tenspresso,第一款晶片就鎖定長上下文推論,與8i Max瞄準同一個領域,不過距離設計完成至少還要一年。此外,包括OpenAI與Anthropic也都在自研晶片,團隊中不乏TPU老將。
更大的變數是AI基礎設施支出可能放緩。美國期中選舉後,資料中心建設計畫再添疑慮;Singh估計,各地對資料中心的反彈,可能讓科技業原本預期的1.4兆美元(約合新台幣46.2兆元)支出,在2027年縮水約5%至7%。
資料來源:Google 官方部落格、《Bloomberg》
本文初稿為AI編撰,整理.編輯/ 李先泰