Google Research今天宣佈,世界準確度最高的自然語言解析器SyntaxNet開源。Google開源再進一步。據介紹,Google在該平台上訓練的模型的語言理解準確率超過90%。近日,眾多科技巨頭人工智慧相關平臺開源步伐明顯加快:Google和Facebook一直領頭,馬斯克的OpenAI欲打造一個完全公開的AI模型訓練營,就連一直被批評「保守」的亞馬遜也在嘗試開源。這一股開源熱潮背後,是人工智慧研究者的福利,但同時也是一場激烈的資料和平臺爭奪戰。
Google環境計算(Ambient computing) 架構師Yonatan Zunger說:事實上,語言理解被我們認為是「AI的終極任務」,要解決這一難題,前提是要能解決全部人類水準人工智慧的問題。
機器對語言的理解過程,可以分為幾個步驟,其中很多的不確定性是逐漸明晰的(語音辨識的不確定性更多,因為還要解決從聲音到詞的轉換)。
第一步是要把詞分開,放到依存樹上,看哪一個詞是動詞,對名詞有哪些影響等等。
隨後,要理解每一個名字的含義。
再次,再加入許多先驗知識,即對這個世界的理解,因為很多句子只有使用了這些資訊才能真正理解。如果足夠幸運的話,到這就能得到清晰的理解了。
Google資深研究科學家Slav Petrov在Google Research的部落格上寫到:在Google,我們花費了大量的時間在思考,電腦系統如何才能閱讀和理解人類語言,以一種更加智慧的方式處理這些語言?今天,我們激動地跟大家分享我們的研究,向更廣闊的人群發佈SyntaxNet。這是一個在TensoFlow中運行的開源神經網路框架,提供自然語言理解系統基礎。我們所公開的包含了所有用你自己的資料訓練新的SyntaxNet模型所需要的程式碼,以及Paesey McParseface——我們已經訓練好的,可用于分析英語文本的模型。
Paesey McParseface 建立於強大的機器學習演算法,可以學會分析句子的語言結構,能解釋特定句子中每一個詞的功能。此類模型中,Paesey McParseface是世界上最精確的,我們希望他能説明對自動提取資訊、翻譯和其它自然語言理解(NLU)中的應用感興趣的研究者和開放者。
SyntaxNet是怎麼運作的?
SyntaxNet是一個框架,即學術圈所指的SyntacticParser,他是許多NLU系統中的關鍵元件。在這個系統中輸入一個句子,他會自動給句子中的每一個單詞打上POS(part-of-Speech)標籤,用來描述這些詞的句法功能,並在依存句法樹中呈現。這些句法關係直接涉及句子的潛在含義。
舉一個很簡單的例子,看下面這個句子「Alice saw Bob」的依存句法樹:
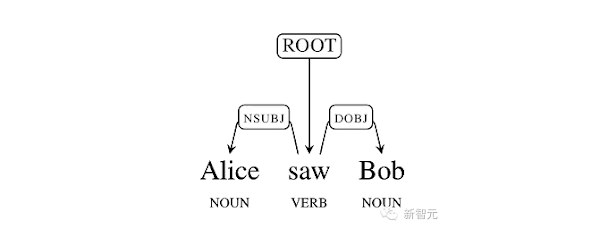
在這個結構中,Alice和Bob被編碼為名詞,Saw是動詞。只要的動詞saw 是句子的根,Alice是saw的主語,Bob是直接賓語(dobj)。和期待的一樣,Paesey McParseface能正確地分析這一句子,也能理解下面這個更加複雜的例子:

句子:Alice, who had been reading about SynataxNet, saw Bob in the hallwayyesterday
在這個句子的編碼中,Alice和 Bob的分別是saw的主語和賓語,Alice由一個帶動詞「reading」的關係從句來修飾,而saw則由時態「yesterday」來修飾。依存句法樹中的語法關係讓我們可以輕易地找到不同問題的答案,比如,Alice看見了誰?誰看到了Bob?Alice正在讀的是什麼?或者Alice是在什麼時候看到Bob的。
為什麼讓電腦正確處理句法分析如此困難?

句法分析如此困難的一個主要問題是,人類語言具有顯著的歧義性。包含 20 到 30 個單詞的中等長度的句子會具有數百、數千甚至數萬種可能的句法結構,這樣的情況並不少見。一個自然語言句法分析器必須能夠搜索所有這些結構選擇,並找到給定語境下最合理的那個結構。作為一個非常簡單的例子,「Alice drove down the streetin her car」這個句子就具有至少兩種可能的依存分析:
第一種分析是對應這句話的(正確)解釋,按照這種解釋,愛麗絲在汽車裡進行駕駛,而汽車位於街道上;第二種分析對應於一種對這句話的(荒誕但仍然可能的)解釋,按照這種解釋,愛麗絲在街道上駕駛,而街道位於汽車之內。之所以會產生這種歧義,是因為「in」這個介詞既可以用來修飾「drove(駕駛)」也可以用來修飾「street(街道)」。上面這個例子是所謂的「介詞短語附著歧義」的一個實例。
人類在處理歧義方面有超強的能力,以至於人們甚至注意不到句子有歧義。而這裡的挑戰是,如何能讓電腦做到同樣好。長句中的多重歧義會共同造成句子的可能結構數量的組合爆炸。通常,這些結構中的絕大多數都極其不合理,但它們仍然是可能的,句法分析器必須以某種方式來丟棄它們。
SyntaxNet 將神經網路運用於歧義問題。一個輸入句子被從左到右地處理。當句子中的每個詞被處理時,詞與詞之間的依存關係也會被逐步地添加進來。由於歧義的存在,在處理過程的每個時間點上都存在多種可能的決策,而神經網路會基於這些決策的合理性向這些彼此競爭的決策分配分數。出於這一原因,在該模型中使用 Beam Search (集束搜索)就變得十分重要。不是直接取每個時間點上的最優決定,而是在每一步都保留多個部分性假設。只有當存在多個得分更高的假設的時候,一個假設才會被拋棄。下圖將展示的,是「I booked a ticket to Google」這句話經過從左到右的決策過程而產生的簡單句法分析。

而且,正如我們在論文中所描述的,十分重要的一點是,要把學習和搜索緊密整合起來才能取得最高的預測準確度。Parsey McParseface 和其他 SyntaxNet 模型是我們用Google的 TensorFlow 框架訓練過的最複雜的網路結構。透過利用Google支援的 Universal Treebanks 專案中的資料,你也可以在自己的機器上訓練句法分析模型。
Parsey McParseface 的準確度到底有多高?
在(從具有二十年歷史的賓大樹庫Penn Treebank中)隨機抽取的英語新聞句子構成的標準測試中,Parsey McParseface 在提取詞之間的個體依存關係時的準確率超過 94%,這打敗了我們自己先前的最高水準,也超過了任何以前的方法。
儘管在文獻中並沒有關於人類的句法分析成績的明確研究,我們從我們內部的句法標注專案中瞭解到,那些在該任務上受過訓練的語言學家在 96-97% 的情況下能達成一致。這說明,我們正在接近人類的水準——不過這仍然限於那些格式良好的文本。按照我們從 Google WebTreebank (+發佈於 2011 年)中所學到的,那些從網路上獲得的句子要遠遠更難分析。在該網路資料集上,Parsey McParseface 只取得了略高於 90% 的句法分析準確率。
**儘管準確率還不夠完美,它已經足夠高,能夠用於許多應用程式了。**目前,錯誤的主要來源是像上面描述過的介詞短語附著歧義這樣的情況,對這些情況的處理要求對現實世界的知識(例如,「街道不太可能位於汽車之內」)和深度語境推理。機器學習(特別是神經網路)已在解決這些歧義方面取得了顯著的進展。不過我們仍想做進一步的工作:我們想要發展出一些方法,這些方法能夠學習現實世界知識,也能夠在所有語言和語境中都取得同樣好的自然語言理解。
想試試嗎?請閱讀 SyntaxNet 的程式碼。並下載 Parsey McParseface 句法分析模型。主要研發者Chris Alberti, David Weiss, Daniel Andor, Michael Collins 和 Slav Petrov 祝你成功。
本文授權轉載自:虎嗅網