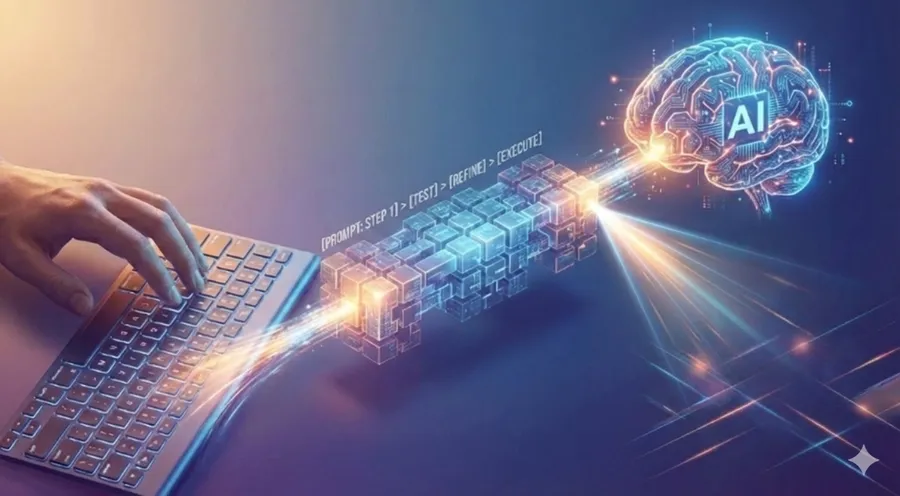
你的提示詞,還停在結構型嗎?以我實務上的分法,提示詞架構大致可以分成兩大類:結構型負責把「要什麼」交代清楚,推理型負責讓AI「想清楚了」再回答。
曾有位品牌主問我一個問題:「我把背景、角色、格式都寫得清清楚楚了,為什麼AI給的建議還是流於表面?」我請她把提示詞拿出來看,架構確實工整,CO-STAR(提示詞框架,涵蓋背景、任務、風格、基調、受眾、格式等要素)該有的元素一應俱全,唯獨少了一件事:她只要求AI「回答」,沒有要求AI「思考」。這篇文章要談的,就是這塊拼圖:推理型提示詞。
結構是骨架,推理是流程
結構型提示詞解決的是「把要什麼說清楚」,推理型提示詞解決的是「讓AI想清楚了再回答」。兩者處理的問題不一樣:格式、語氣、角色這些交代清楚,AI確實不會答非所問;但面對多變數交叉比較、多方案評估或策略推演這類需要拆解、驗證、修正的任務,光靠結構完整的提示詞還不夠,因為AI很容易直接給出第一個想到的答案,跳過中間該有的判斷過程。
我認為,結構型提示詞決定AI會說什麼,推理型提示詞讓AI想清楚再說。
六個常用的推理型提示詞
好的推理不是靠AI自己頓悟,而是靠提示詞把思考的順序、範例、驗證與修正機制設計進去。以下六個是我最常拿出來用、也最常推薦給品牌主的推理型框架,其中五個有明確的學術出處,我也簡單做了註記。
1. Chain-of-Thought:讓AI把推理過程寫出來
CoT出自2022年Google團隊的研究,主張要求AI先逐步列出推理步驟再下結論,複雜任務的正確率會明顯提升,尤其在數學、邏輯與多步驟判斷這類有明確對錯的任務上最有感;不過原研究也指出,這個效果要在夠大的模型上才會出現。例如:「你是財務顧問;請先列出影響本季毛利下滑的三個可能因素,再逐一評估其影響程度,最後才提出定價調整建議。」
適用領域:多變數交叉比較、財務與定價決策、複雜策略推演。
2. Self-Consistency:讓AI對自己的答案做交叉驗證
同樣源自Google團隊的延伸研究,做法是讓AI針對同一個問題跑出好幾條不同的推理路徑,再看哪一個答案重複出現最多次,用多數決取代單次判斷,彌補CoT只推理一次的不足。例如:「請針對這個定價策略的合理性,獨立推理三次,過程不要互相參考;最後比對三次的結論,告訴我哪一個答案重複出現、哪些推理步驟彼此不一致。」
適用領域:重大決策驗證、高風險判斷、需要交叉比對的策略分析。
3. Few-Shot:用範例教會AI判斷邏輯
Few-Shot的概念因OpenAI在2020年GPT-3的論文而廣為人知,該研究證明大型模型不需要重新訓練,光靠提示詞裡的幾個範例就能抓到任務要領。實務上給二到三個範例通常就有感,AI會從中學習格式與判斷標準,而不是憑空猜測。例如:「以下是三則過去的客服回覆範例,請依照相同的語氣與結構,回覆這則新的客訴。」
適用領域:品牌語氣複製、客服範本化、內容分類與標記。
4.Skeleton-of-Thought:先搭骨架,再展開內容
這個做法借用了SoT的骨架概念:要求AI先列出大綱骨架,確認架構無誤後,再逐段展開細節,避免長文一次生成就跑偏。要注意的是,SoT原論文(2023年,由清華大學與微軟研究院團隊發表)的設計目的其實是加速生成——先列骨架,再把各段落平行展開後合併,最高可加速2.39倍;拿它當成人工確認點,是實務上的延伸用法。例如:「請先列出一份年度趨勢報告的五個章節骨架,我確認方向後,你再逐段展開內容。」
適用領域:長文報告、簡報大綱、結構複雜的內容產出。
5. Self-Refine:讓AI自己修改自己
Self-Refine出自2023年由卡內基美隆大學等機構共同發表的研究,要求AI先產出初稿,再切換角色自我審查,最後根據問題修正成定稿,適合對品質要求極高的輸出。例如:「請先寫一份新聞稿草稿,接著扮演審稿編輯挑出三個問題,最後根據問題修改成定稿版本。」
適用領域:對外文案精修、法遵與公關稿件、需要多輪校對的內容。
6. Role Prompting:借一個角色的判斷邏輯
Role Prompting沒有單一的學術源頭,卻長期是實務上最通用的技巧之一:賦予AI一個具體的專業角色,讓回答貼近那個角色會有的用語與判斷方式,而不是泛泛而談。要留意的是,近年也有研究指出,角色設定對客觀任務的正確率幫助有限,真正被改變的主要是語氣與切入視角——把它當成「換一副眼鏡看問題」,會比當成「提升準確度」更貼近實際。例如:「你是一位有十年經驗的品牌稽核顧問,請從風險控管角度,檢視這份行銷方案有哪些潛在爭議。」
適用領域:專業視角模擬、風險評估、跨部門溝通模擬。
結構與推理,怎麼一起用
我常提醒品牌行銷團隊,這些提示詞不是二選一。如果說CO-STAR、RCTCO(一種提示詞框架,包含角色、背景、任務、限制條件、格式)這類結構型提示詞決定了AI站在哪裡,推理型提示詞決定的就是它怎麼走過去。如果要寫一份給高階主管看的策略建議,可以先用RCTCO交代角色、背景與限制,再用Chain-of-Thought要求AI把推理步驟攤開來,遇到高風險判斷就加一次Self-Consistency交叉驗證,最後用Self-Refine讓它自己挑一次毛病。
少了結構,AI會想得沒方向;少了推理,AI會答得沒深度。這也是為什麼我認為,好的提示詞從來不是單一招式,而是一套組合拳。
好問題,才有好答案;但唯有好的推理過程,才能讓好答案禁得起檢驗!
本文授權自高端訓【品牌AI攻略】