Anthropic在10月13日的工程部落格裡寫下一組數字:2026年5月,公司每天平均合併約2,500筆程式碼變更;到了9月,每天超過3萬筆,四個月成長超過十倍。
負責Claude Code開發者關係的Anthropic技術人員Lydia Hallie,在11月12日上線的AI Engineer演講中,這樣描述Anthropic內部的工作形態:
工程師從一次盯著一、兩個session(Claude Code的工作階段),變成同時管幾十個,每個跑好幾小時,中途自己驗證結果,甚至由一個session指揮其他session。「我們基本上變成了幾十個session的管理者。」
這場演講的標題是「重新思考Claude Code最佳實踐」,簡介的主張是:模型變強之後,過去一年大家堆進設定裡的東西,很多正在拖累新模型。
乍看是在教人做減法,但真正的重點是減法之後要補什麼。該少的,是你對AI的叮嚀;該多的,是你對環境的設限。
這套邏輯在寫程式的世界先跑了一遍,但其實對任何準備把整件工作交給AI的人,都是一份提前到的參考答案。
一年前的正確用法,已經過時了
Hallie先回放今年初的典型畫面。當時的主力模型是Opus 4.5,她說以當時標準已經很好用,但它會提早停下來,人得不斷提醒它該做什麼。於是不少人在CLAUDE.md(給Claude Code讀的專案說明檔)裡加進「IMPORTANT!」「絕對不要這樣做!」這類加驚嘆號的強硬指令;auto mode(由分類器代替人判斷核准的自動模式)還不存在,每一條指令要麼人工逐條按允許,要麼冒險整個關掉權限檢查。
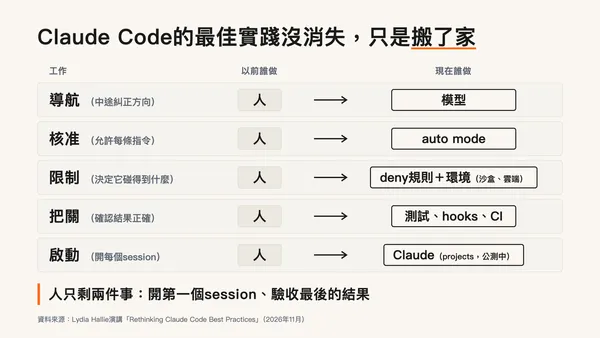
換句話說,人在迴圈裡的每一步都有理由,模型會偏,所以要導航;模型會闖禍,所以要逐條核准;模型做完不確定對不對,所以要逐檔看改動。
回到現在来看,這些做法只在那個時間點是對的。
模型變強之後,叮嚀反而變成干擾
Opus 5.5上線後,情況反過來。Hallie說新模型更懂你的意圖和程式碼,不必再像以前那樣頻繁導航;加驚嘆號的強硬指令不只沒必要,還可能讓模型偏離方向,導致工具呼叫變多、結果更差。她給的新原則很簡單:
CLAUDE.md只留程式碼看不出來的事。
例如某個服務還連著一個舊的資料來源,程式碼裡卻沒有直接引用,這種值得留;用了什麼技術、檔案放在哪,模型自己看得出來,刪掉。
他並建議使用Claude Code內建的/doctor prompt-audit指令會自動檢查CLAUDE.md和各種技能檔,列出新模型已經不需要的指示。
這就是「少」的部分。她說,光是換成現行預設值(新模型加auto mode),人過去在迴圈裡做的事就已經去掉大半。真正難的問題在後面:人不在場了,怎麼確定這樣沒問題? 她把答案拆成兩件事,安全和驗證。
收得回來的放手,收不回來的寫死
Anthropic在8月公布一項對照實驗:1,053名付費專業測試者面對明顯危險的指令,只有13.6%的人攔下來;auto mode的分類器攔下89%。人站在旁邊按允許,看起來最安全,在這項實驗裡卻只攔下13.6%。
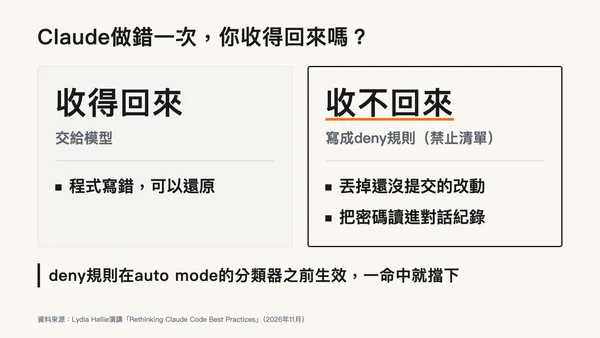
Hallie給了一條判準:如果Claude做錯一次,那個錯誤的結果,你收得回來嗎?
如果收得回來的交給模型,程式寫錯可以還原。但收不回來的,像丟掉還沒提交的改動、把密碼讀進對話紀錄,就寫成deny規則(禁止清單),它在分類器之前生效,一命中就擋下。例如一條「不准讀取.env檔」,Claude的讀檔工具就打不開它。
但麻煩的是,但有些事連規則都管不到。
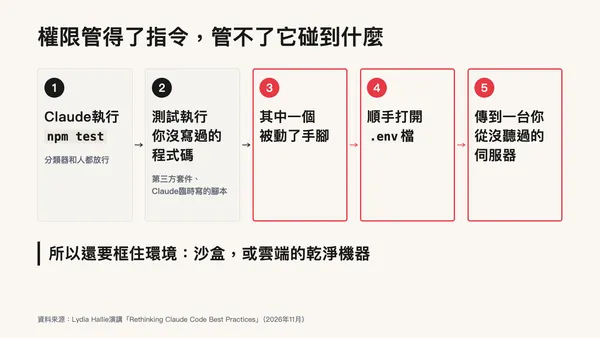
npm test是再普通不過的跑測試指令,分類器和人都會放行;可是測試一跑,執行的是你沒寫過的程式碼,像第三方套件或Claude臨時寫的腳本。只要其中一個被動了手腳,就能順手打開同一個.env檔,傳到一台你從沒聽過的伺服器。
也就是說,權限只管一條指令能不能跑,但管不了它跑起來之後碰得到什麼。
所以還要框住環境。在自己的電腦上,可以把指令丟進沙盒(sandbox),由作業系統限制它能讀哪些檔、連哪些地方,連它另外啟動的程式也一併受管。
她更推薦在雲端開session:一台乾淨的獨立機器,從程式碼倉庫重新複製一份開始,不會自動帶入本機未提交的檔案與憑證。 機器用完可以丟,但推出去的東西收不回來,所以deny規則和auto mode仍要留著。
這就是「多」的部分:人退出的每一步,都換成一道由模型以外的東西執行的限制或檢查。
不看全部過程,只看驗證點
安全解決了,還有品質。過去每個改動都經過人的眼睛,品質是順便確認的;現在Claude在背景跑好幾個小時,你不會回頭讀每個檔案。
Hallie舉例:同樣一句「把登入系統搬到新的API」,可能搬完卻留著舊API,可能只搬了新登入的使用者,也可能把所有人登出。三種結果看起來都合理。
她的解法是設驗證點:任何能回答「過或沒過」的東西都算,測試、建置、截圖。人只看驗證點,比最後看整包改動省得多。做法分三層:
指令裡寫清楚「完成長什麼樣」,請它拆成任務、各配測試,並貼出實際輸出。
一定要跑的檢查用hooks(自動檢查腳本)綁在固定時機:改了檔、要標記完成、要結束session,各跑對應的檢查。檢查失敗,hooks會擋住它標記完成或結束,Claude就得回頭處理。
到團隊層級交給CI(每次提交程式碼自動跑的檢查):每個PR(合併請求)都跑同一套檢查,沒過Claude自己回去修。
她所在的Claude Code團隊再加一道:每個PR先由另一個不帶原session記憶的Claude審查,另一組agent複核它找到的bug。
人工審查的量則依風險決定:文件、文案自動檢查全綠就不必有人看,一般變更大概一人審,高風險的可能要兩人。自動合併不是預設。
人還剩什麼事?
Hallie描述的下一步,是連「開每個session」這件事都交出去。Claude Code projects(截至11月16日仍是公測,只開放給Pro、Max、Ultra個人方案)讓一個主session負責拆工作、派給其他session、追蹤回報,自己不寫程式;她建議主session用擅長判斷的Fable,實際動手的session用Opus 5.5,什麼時候該壓縮或清除對話脈絡也不必再管。
要留意的是,projects派出去的雲端session不套用程式碼倉庫設定檔裡的deny規則,也不執行其中的hooks;要用這兩樣,得讓那條session在自己電腦上跑。
她的結語是:過去的最佳實踐都還在,只是搬了家。導航交給模型,核准交給auto mode,能做什麼由deny規則和環境限制,把關交給測試、hooks和CI,連啟動也能交給Claude。人只剩兩件事:開第一個session,還有驗收最後的結果。
她給想試的人一個起手式:挑一件比平常交給Claude的大很多的任務,先確認CI抓得到你在意的事,設好網路權限和機密,丟到雲端跑,然後看它卡在哪裡,因為卡住的地方,就是下一件該交出去的事。
換成你的工作也一樣:先找出哪些事有過或沒過的檢查點,那些才是能放手的;找不到的,人還得留在迴圈裡。
給Claude Code使用者:現在就能做的5個調整
執行
/doctor prompt-audit,刪掉CLAUDE.md裡新模型不再需要的指示(需Claude Code v2.1.283以上)。在
settings.json的permissions.deny加入Read(./.env),擋住Claude的讀檔工具與它認得的cat等指令;腳本自行開檔要靠沙盒,沙盒也管不到MCP伺服器和hooks。用TaskCompleted、Stop這類hooks阻擋完成時,檢查失敗要回傳exit code 2;回傳1只算一般錯誤,任務仍會被標成完成。
下指令時先寫清楚「完成長什麼樣」,要求拆成任務、各配測試,並貼出實際輸出。
雲端session需要API金鑰時設成network secret,由代理伺服器附在請求上,模型看不到;單一repo的一般雲端session會讀repo裡
.claude/settings.json的deny規則和hooks,所以要commit進repo才帶得走;projects的雲端session則不套用這兩者。
資料來源:Lydia Hallie演講「Rethinking Claude Code Best Practices」、Anthropic工程部落格「Redesigning source control at Anthropic」、Claude官方部落格「Auto mode is now the default in Claude Code」、Claude Code文件:權限設定、Claude Code文件:hooks、Claude Code文件:雲端環境、Claude Code文件:Projects
本文初稿為AI編撰,整理.編輯/ 李先泰