

你存了幾百篇文章,打了幾十份筆記,但要用的時候怎麼也找不到。
這不是你的問題。知識管理最耗人的部分,從來不是「讀」和「想」,而是整理:把資訊分類、建立連結、讓舊筆記和新資料串起來。
OpenAI 共同創辦人安德烈·卡帕西 (Andrej Karpathy) 最近公開了他的解法:讓 AI 代替你做這些整理工作。
你只需要把資料丟進去,剩下的摘要、分類、交叉連結、維護——全部交給 AI。他自己用這個方法,在某個研究主題上累積了將近 100 篇筆記、40 萬字,而且查得動。
這篇文章說明這套系統怎麼運作,以及怎麼用最快的方式把它建起來。
你需要準備什麼?
1. Obsidian(免費)
存放筆記的桌面應用程式。所有筆記存在你自己的電腦上,不上傳雲端。到 obsidian.md 下載,安裝後建立一個新的「保險庫」(Vault),這就是你的知識庫所在地。
如果你是第一次使用 Obsidian,可以先參考這篇入門教學。
2. Obsidian Web Clipper(免費)
瀏覽器擴充功能,讓你在看網頁文章時,一鍵把整篇文章存進 Obsidian,格式乾淨不跑版。
在瀏覽器的擴充功能商店搜尋「Obsidian Web Clipper」安裝即可。
3. Claude Code(需要 Anthropic 帳號)
這是整套系統的核心,也是和一般 AI 工具最不一樣的地方。
一般的 ChatGPT 或 Claude 網頁版只能在對話框裡交換文字。Claude Code 則可以直接進入你的資料夾,讀取筆記、寫入新內容、更新目錄,就像一個能操作你電腦的 AI 助理,不需要人工複製貼上。
前往 claude.ai/code 下載 Mac 或 Windows 的桌面應用程式。
關鍵是需要Anthropic 帳號,Claude Pro 訂閱方案(每月約 20 美元)包含 Claude Code 的使用權限。如果你對 Claude Code 還不熟悉,可先參考這篇入門教學。
最快的起步方式?
準備好之後,打開 Claude Code,把它指向你的 Obsidian 保險庫資料夾。有兩種方式可以讓它幫你把系統建起來:
方法一:餵入卡帕西的原始文件(英文)
把以下指令貼給 Claude Code:
請根據以下卡帕西的 GitHub Gist,在這個資料夾裡幫我建立 LLM 知識庫系統,並說明我接下來要怎麼使用:
> [https://gist.github.com/karpathy/442a6bf555914893e9891c11519de94f)
方法二:使用完整架構說明文件
AI 研究者 Elvis Saravia 根據卡帕西的系統整理了一份完整的架構說明文件,並發布在 dair.ai。
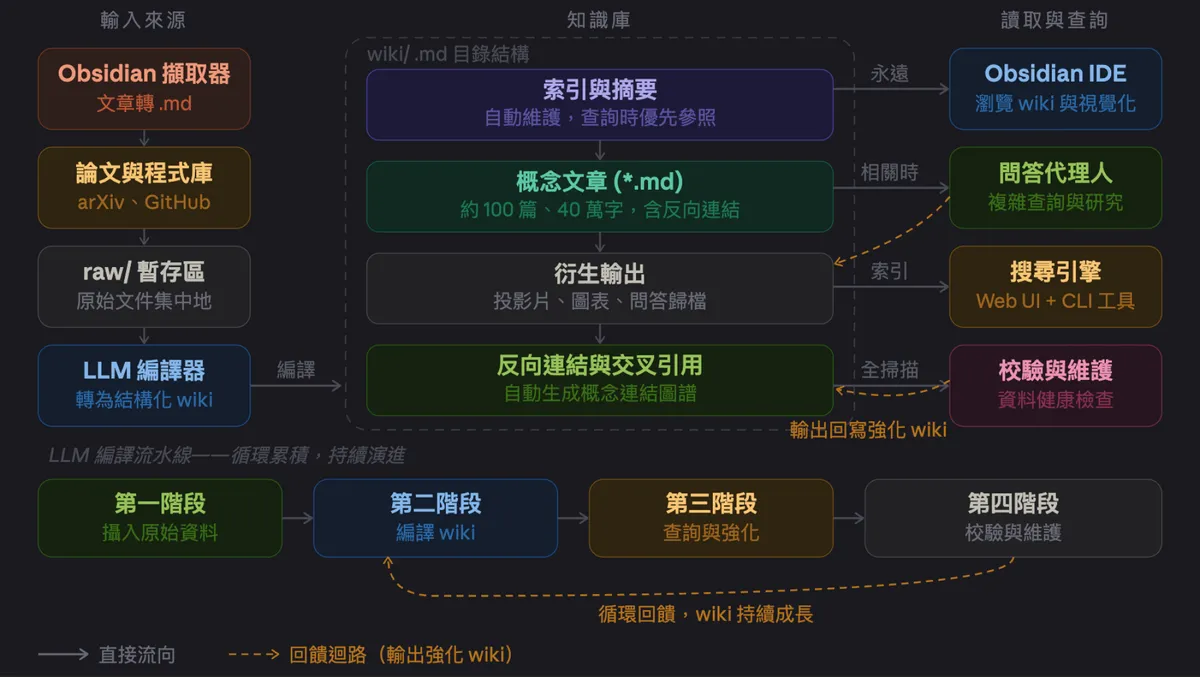
把這份文件直接貼給 Claude Code,它就能根據完整的架構說明建立系統,細節比方法一更豐富一些,整體架構如下:
現在把以下指令全部複製,貼給 Claude Code,並在最後加上一句:「請根據以上架構,在這個資料夾裡建立系統,所有筆記使用繁體中文,完成後告訴我怎麼開始使用。」
# LLM Knowledge Bases - Architecture (Karpathy)

## Overview
A personal knowledge base system where an LLM acts as a compiler that reads raw source documents and produces a structured, interlinked markdown wiki. No vector databases or embeddings needed at personal scale.

## Phase 1: Ingest
- Obsidian Web Clipper: Browser extension converts web articles into clean .md files with locally downloaded images
- Papers & Repos: arXiv papers, GitHub repos, datasets collected into raw/ staging directory
- raw/ directory: All source documents land here first - the LLM reads from this staging area

## Phase 2: Compile (LLM Compiler)
The LLM incrementally reads raw/ and builds a structured wiki:
- Index & Summaries: Auto-maintained index files with brief summaries of all documents - entry point for queries
- Concept Articles: ~100 articles, ~400K words, organized by topic with backlinks and cross-references
- Derived Outputs: Marp slide decks, matplotlib charts, filed-back query answers
- Backlinks & Cross-links: Auto-generated link graph between concepts, finding connections for new article candidates

## Phase 3: Query & Enhance
- Obsidian IDE: Frontend for browsing the wiki and visualizations
- Q&A Agent: Complex research questions across articles - answers rendered as markdown, slides, or charts
- Search Engine: Vibe-coded naive search over the wiki, usable via web UI or as a CLI tool for the LLM
- Key insight: Outputs from queries get filed back into the wiki - every exploration adds up

## Phase 4: Lint & Maintain
- Scan for inconsistent data
- Impute missing information via web search
- Find connections between concepts for new articles
- Suggest further questions to explore
- After linting, cycle returns to Phase 2 - wiki keeps growing

## Feedback Loops
- Q&A Agent outputs -> filed back into wiki (Derived Outputs)
- Linting results -> enhance the wiki
- Phase 4 cycles back to Phase 2 continuously

## Future Direction
Synthetic data generation from the wiki to fine-tune an LLM so it "knows" the data in its weights rather than just through context windows.

## Tools Used
- Obsidian (IDE + file viewer)
- Obsidian Web Clipper (article ingestion)
- LLM with large context window (compilation)
- Markdown directory structure (wiki storage)
兩個方法的效果一樣:Claude Code 會照著說明把整個系統建好,並告訴你後續怎麼操作。不需要手動設定任何東西。
這套系統怎麼運作?
整套系統由三個區域和四個動作組成:
三個區域:
raw/原始資料夾:你蒐集的所有原始素材,只進不改wiki/知識庫:AI 整理好的筆記,每個概念一篇,互相連結index.md+log.md:目錄與整理記錄,由 AI 自動維護
四個動作:
- 蒐集:用 Obsidian Web Clipper 把網頁文章存進
raw/ - 整理:讓 Claude Code 把原始資料編譯成知識庫筆記
- 提問:對知識庫問問題,把回答也存回去累積
- 清理:定期讓 AI 掃描知識庫,找矛盾、補缺漏
蒐集資料
看到一篇好文章,點一下瀏覽器上的 Obsidian Web Clipper,文章就自動存進原始資料夾(raw/)。PDF、截圖、逐字稿,直接拖進去就好。這個資料夾只進不改,是你所有知識的原始存檔。
讓 AI 整理
每次累積了幾篇新資料,在 Claude Code 下一個指令,它會自動讀取原始資料、為每個概念建立或更新筆記、在相關筆記之間加上連結,並更新整座知識庫的目錄。整個過程你不需要複製貼上任何東西——Claude Code 直接在你的 Obsidian 資料夾裡寫入修改。
問問題,把答案存回去
知識庫累積到一定規模,就可以開始對它提問。問題可以很廣:「幫我整理 XX 主題的重點」、「我在這個領域還有哪些盲點」、「把這些筆記的矛盾找出來」。
卡帕西的做法是讓 AI 把回答也整理成新筆記,直接存回知識庫——讓每一次提問都成為知識的一部分,而不是問完就消失。目前他在某個研究主題上的知識庫已達約 100 篇筆記、40 萬字,在這個規模下可以提出相當複雜的問題。
定期清理
每隔一段時間,讓 Claude Code 掃描整座知識庫,找出頁面之間的矛盾、過時的資訊、以及值得深入的新方向。AI 在這個環節也很擅長主動建議下一步值得追問的問題。
為什麼這樣做有意義?
傳統知識管理工具,無論是 Notion、Roam 還是 Obsidian,都把整理的苦工甩給人做。連結要人建、標籤要人貼、矛盾要人找。大多數人最終放棄,不是因為沒有毅力,而是維護成本超過了回報。
LLM 知識庫把這個成本轉移給 AI:人負責找素材、定方向、問好問題;AI 負責摘要、交叉連結、一致性維護。
卡帕西在公開這套方法時留下一句話:
「我認為這裡有空間誕生一個了不起的產品,而不只是一堆雜七雜八的腳本。」
目前這套系統還需要自己動手搭建,但它的邏輯已經完整。選一個方法,把文件餵給 Claude Code,就是開始的第一步。
資料來源:Andrej Karpathy GitHub Gist、Karpathy X 貼文、Elvis Saravia / dair.ai
本文初稿為AI編撰,整理.編輯/ 李先泰


