OpenAI宣布一項數學研究成果後,曾使用Codex協助研究的數學家Buckmaster公開追問:你們有沒有拿我的對話訓練模型?
OpenAI否認該項研究查閱過用戶資料,但表示,會使用用戶回饋與去識別化資料改進ChatGPT與Codex。
這也帶出一般用戶的疑問:我上傳的合約、簡報與程式碼,會不會成為AI的訓練素材? 答案取決於方案、設定及是否提供回饋。
《數位時代》以下整理9個隱私關卡,再教你關閉訓練、管理記憶與取消分享。
你按下送出後,那份合約去了哪裡?
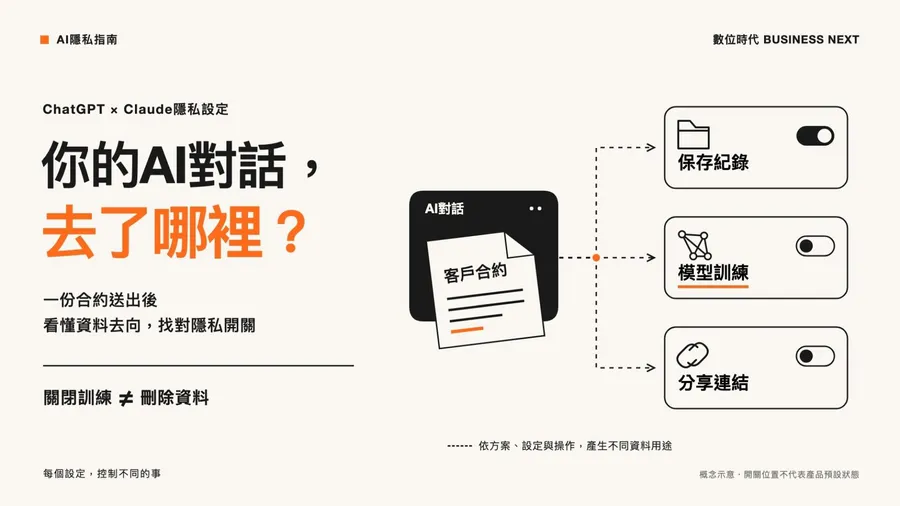
以情境舉例:下午3點,你把一份客戶合約上傳到Claude,輸入:「幫我摘要風險。」
接下來,合約會加密傳到平台,由AI處理並回答。但回答結束,不代表資料就消失了:對話可能留在歷史紀錄裡;特定情況下,授權人員可能查看;是否用於模型訓練,則取決於方案、設定及是否提供回饋。ChatGPT也有類似機制,但細節不同。
先記住:關閉訓練、關閉記憶與刪除對話,是三件不同的事。**每個操作能控制的範圍不同,不能只關掉一個開關,就以為資料都清乾淨了。
下方整理9個與對話隱私有關的環節。點開卡片,可以查看兩家的差異,以及你能採取的動作。這些環節不一定全部發生,也不是固定先後順序。
想減少資料被保留或利用,先做這4件事
- 上傳前,先確認帳號與資料
客戶合約、公司機密或個人健康資料,先確認公司是否允許上傳,以及指定使用哪個方案。企業方案預設不拿資料訓練,也不代表任何資料都適合放入。能先去掉姓名、帳號與不必要內容,就只留下分析需要的部分。
- 不想提供訓練,關閉模型改善
ChatGPT進入「設定→資料控管」,關閉「為所有人改善模型」;Claude進入「設定→隱私權」,關閉模型改善。選單名稱以實際介面為準。
關閉訓練不會刪掉歷史對話。含敏感內容的對話,也避免再透過讚、倒讚提交回饋,因為相關整段內容仍可能用於訓練。Codex另有完整環境訓練設定,須分開檢查。
- 不想留下個人化資訊,分開管理記憶與對話
兩家的記憶功能都能在設定中管理,但「停用」與「刪除」不同。Claude的「暫停記憶」會保留既有內容,想清除須選「重設記憶」;ChatGPT也須另行刪除相關記憶及對話等來源。
臨時提問可使用ChatGPT臨時對話或Claude無痕對話,但仍可能有保留期限與企業管理規則。ChatGPT臨時對話若不想引用既有記憶,開始時還要選擇非個人化。
- 用完後,檢查檔案與分享連結
刪除對話之外,也要確認上傳檔案是否另存於其他位置。例如,ChatGPT存入Library的檔案須另行刪除。
再到兩家的分享管理頁,取消不需要的公開連結。取消分享能停用連結,但無法收回別人已複製的內容。瀏覽器擴充套件與外部工具,也只保留來源可信、權限確有需要的項目。
延伸閱讀:不想讓自己變AI模型訓練素材?教你ChatGPT、Gemini、Claude關閉個資方法
資料來源:Ruben Hassid《How to AI》電子報、OpenAI Navier-Stokes公告、Buckmaster聲明、Mark Chen X貼文、《Fortune》、《Tom's Hardware》、OpenAI資料使用說明、OpenAI消費者資料使用FAQ、OpenAI對話與檔案保留說明、OpenAI分享連結說明、OpenAI記憶功能說明、OpenAI臨時對話說明、OpenAI對法院保存令的說明、OpenAI政府請求報告、Anthropic消費者條款更新公告、Anthropic資料保留說明、Anthropic資料保護說明、Anthropic訓練資料說明、Anthropic訓練資料權利說明、Anthropic無痕對話說明、Anthropic記憶功能公告、Claude記憶功能操作說明、Anthropic政府請求報告、《TechCrunch》Anthropic改制報導、《TechCrunch》Claude分享連結報導、《Fast Company》、OX Security報告、NYT訴OpenAI保存令、NYT訴OpenAI保存令終止裁定、NYT訴OpenAI 2026年1月裁定
本文初稿為AI編撰,整理.編輯/ 李先泰