
機器學習告訴你:《紅樓夢》後40回到底是不是曹雪芹寫的?

前幾天燈神給我發了一篇文章,講的是用機器學習的方式來判定紅樓夢後40回到底是不是曹雪芹寫的。

圖說明

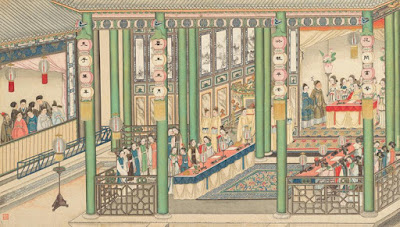
黛玉重建桃花社。畫家孫溫。圖片來自:Wikipedia

我這段時間也在自學Andrew Ng的機器學習課程,還差4週就能完成課程了。

電腦是一個很強調learning by doing的學科,於是我也來「學以致用」,用剛學到的SVM演算法來分析下雪芹老師到底有沒有寫後面的40回。

作為一個從沒看過紅樓夢的人,我的大致思路是這樣的:

  1. 受到《獵人》裡蟻王破解會長無敵招數的啟發,每個人的寫作都有些小習慣,雖然文章前後說的內容會有差別,但是這些用詞的小習慣不容易改變;

  2. 用開源的分詞工具把全書分詞(python的jieba分詞),然後統計詞頻。把出現頻率超過100次的詞語找出來,人工去掉一些可能因為文章內容造成前後出現不一致的人名、地名;

  3. 然後每一章按照2中的詞頻表,看這一章中出現這些詞語的頻率;

  4. 前80回、後40回各選15回作為機器學習的資料,讓機器學習這些章節的用詞特點,然後推算其他章節的用詞特點是屬於前80回呢、還是後40回;

  5. 如果機器根據這些用詞特徵推算的是否屬於後40回的結果跟實際的結果吻合,那麼就說明後40回的寫作風格跟前80回有很大不同,很可能是兩個人寫的;

好了,下面我儘量少涉及數學跟程式設計的知識,來一步步解讀機器學習是怎麼完成這個問題的。

生成全書的詞頻表
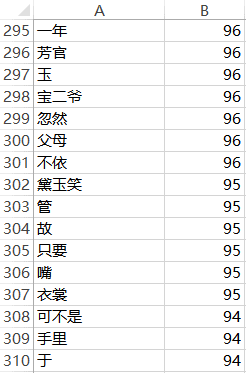
圖說明

我截取了其中一段的詞頻表。像寶二爺、黛玉笑這種涉及人物的詞語,可能前面戲份多、後面戲份少,所以就不選它們作為用詞習慣的特徵,而像忽然、故、只要、可不是這種承接性質的碎詞,就不太容易會受情節的影響,所以適合選出來作為用詞習慣的特徵。

最終,我按照出現從多到少排序,選擇了278個詞作為機器學習的用詞習慣。

將120回的詞頻進行統計

接下來我把每一回出現這278個詞的頻率統計出來,得到我們給機器學習的樣本。這個樣本的樣子大概是這樣的:
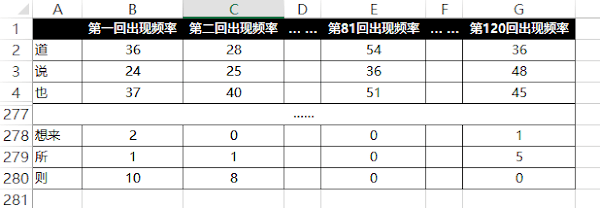
圖說明

比如以B行2列舉例,說明在第一回裡面「道」這個動詞,出現了36次。

通常我們在進行複雜的事情前,喜歡先簡化問題,或者給自己一些直觀的圖表,以便瞭解問題。機器學習也是一樣的。

我嘗試著在圖上把前80回和後40回習慣用詞出現的頻率畫出來。以第一回為例,x1座標代表「道」出現多少次,x2座標代表「說」出現多少次,x3座標代表「也」出現多少次......x280座標代表「則」出現多少次。

什麼?超過三維了,那人類的大腦可是沒辦法理解的啊。

沒關係,當我們用燈光照射一個立體的圖時,平面會有它的影子。這個影子雖然沒有立體圖的資訊這麼豐富,不過我們看影子還是可以猜出來大致的樣子。對於高緯度的問題,我們也可以用投影的方式來降低緯度。

雖然資訊損失了不少,不過能給我們一個直觀的感受。
圖說明

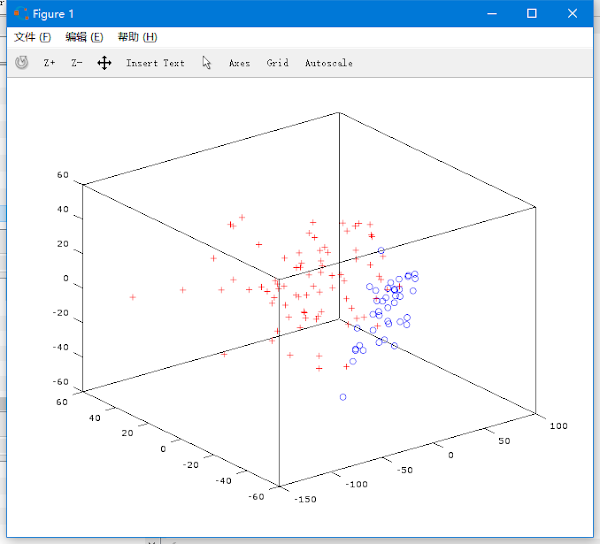
這個是120個章節的用詞習慣從278緯降到3維以後的圖,紅色+的點是前80回,藍色o的點是後40回。

從這個圖可以很直接地看到,確實在用詞習慣上有明顯的區別。就算我們沒有機器學習工具的幫忙,也可以大膽猜測後40回是出自於另外一個人了。

下面我們用機器學習來看精確一點的判斷。

機器學習

透過課程我大致瞭解了SVM的原理和簡化版問題的演算法實現,不過對於複雜問題我還是沒這個能力寫程式。於是用python的scikit庫來幫助我來完成這個預測。

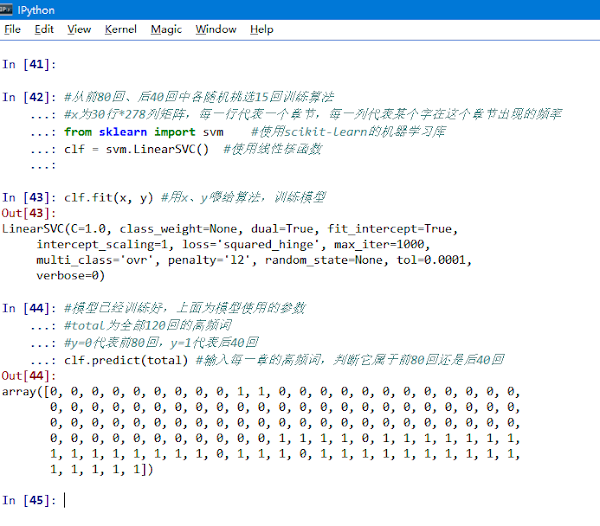
演算法的步驟很簡單,前80回、後40回各選15個來餵給機器學習它們的特點,然後把剩下的章節輸入給機器,問它們屬於前80回還是後40回。
圖說明

看out[44]的結果,代表了機器預測這120回的用詞習慣到底屬不屬於後40回(0為不屬於,1為屬於)。

如果你看不懂上面的程式碼,沒關係。我告訴你結果好了。

機器在學習以後告訴我,如果我把隨便一章的用詞習慣告訴它、但不告訴它到底是前80回還是後40回,那麼機器有95%的把握能猜出它是不是後40回。

至此,我們可以很有信心地判斷它們的寫作風格不同。

那麼,問題來了,會不會因為是情節的需要所以導致寫作風格不同了呢?

情節不同會造成用詞習慣多大的差別?

好吧,那我再來做一個旁證。我把另外一部四大名著「三國演義」拿來分析,看看上部跟下部的用詞習慣會不會有比較明顯的差別。
圖說明

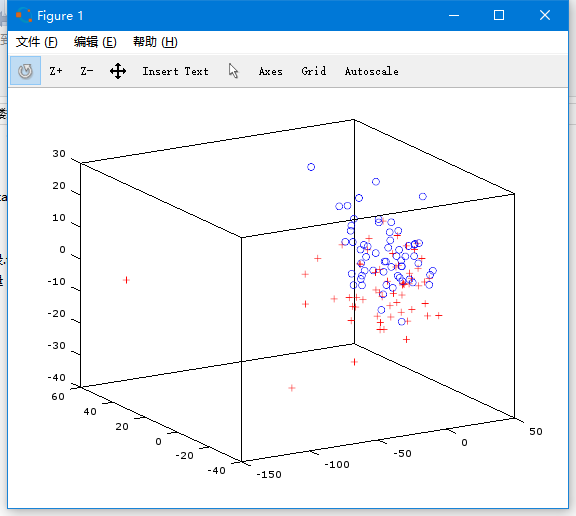
這個是三國演義的用詞習慣縮到三維以後的圖,紅色+代表前60部的用詞習慣,藍色o代表後60部的用詞習慣。

你可能會說,雖然中間交叉的地方比較多,但是還是可以看出來是有區分的。

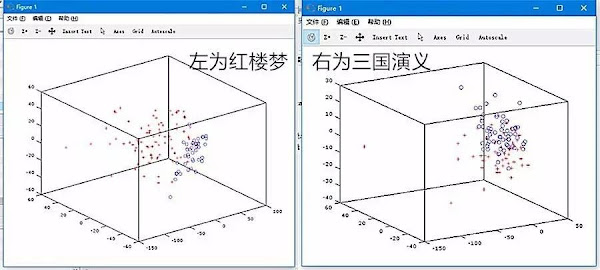
可如果你比對一下跟紅樓夢的圖,你就會發現紅樓夢的差別會明顯得多。
圖說明

紅色+為紅樓夢前80回/三國前60回,藍色o紅樓夢後40回/三國後60回

最後,用機器學習的方式來說,如果我把三國演義隨便一章的用詞習慣告訴它、但不告訴它到底是前60回還是後60回,那麼機器有7成的把握猜對,這個準確度已經遠遠低於紅樓夢的95%的預測水準。

所以,我們用「三國演義」這個旁證來分析,即便是因為情節需要導致的用詞習慣差別也不應該這麼大。

所以,我們就更有信心說曹老先生沒有寫後40回了。

更多的機器學習有趣的玩法,我會在學習的過程中慢慢嘗試的。以上。

本文作者黎晨,原文刊載於他的微信公眾號:黎小晨想太多
關鍵字: #機器學習
往下滑看下一篇文章
從切菜到乾燥加工!宜展如何結合桃園市政府創業資源,以AI開拓農產加工第二成長曲線?

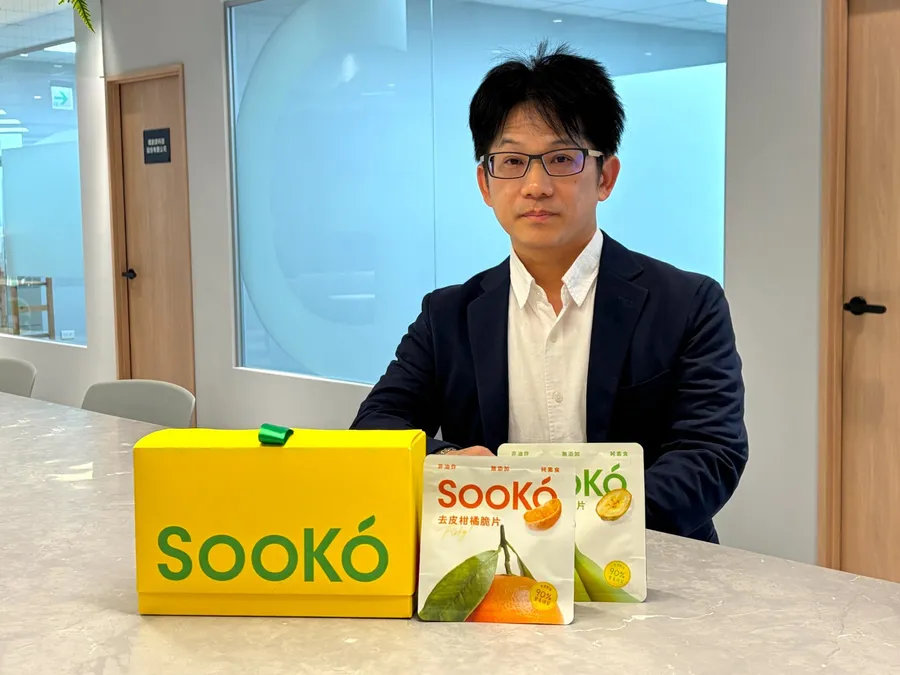
走進蔬果加工廠,同樣是100公斤高麗菜,最後能做出多少成品?答案不見得相同。氣候、產地與品質影響原料條件,客戶要求的切法、重量與交期也各不相同。對曾任科技業研發主管十多年的宜展科技農業執行長林佑澤而言,這是與科技製造截然不同的世界。

「農業部分全部都不一致。」林佑澤以青江菜為例,即使機械手臂已經訓練好辨識特徵,面對形狀各異的蔬菜,仍難以判斷該從哪裡抓取。農產品的天然變數,卻得面對學校團膳、連鎖餐飲、航空空廚等企業客戶對品質與交期的要求。如何讓加工流程穩定運作,成為宜展投入數位轉型的起點。

從紙本、LINE到數據,先把現場經驗留下來

目前宜展一年處理數千噸蔬果、服務超過120家企業客戶,業務涵蓋採購、截切、清洗、包裝與配送。林佑澤觀察,農產加工的關鍵經驗往往掌握在資深員工手中:該買多少菜、原料損耗多少、訂單增加又該安排多少人力,都仰賴現場判斷。

「主要就是把人的經驗變成數據。」林佑澤說。過去客戶透過LINE或紙本下單,現場靠人工整理訂單、對照不同客戶的加工規格;如今宜展利用AI辨識訂單內容並匯入ERP,再依客戶、品項與規格進行標籤化派工。製程則透過QR Code記錄原料投入量與成品產出量,逐步掌握各環節的加工損耗。

接下來是整理現場的判斷依據。林佑澤透過與資深員工對談,了解採購、派工與品管的作業方式,再利用AI協助找出規則、建立SOP。AI整理出的流程仍須由現場人員逐項確認、修正,才能實際執行。

品質管理也在持續改善。傳統金屬檢測器難以辨識菜蟲、橡皮筋等非金屬異物,宜展正與技術夥伴規劃導入AI影像辨識,輔助產線末端檢查。林佑澤表示,每批農產品品質不同,比起單看良率,他更重視客訴是否減少。隨著訂單與製程資訊逐步累積,宜展也希望進一步建立需求預測、採購建議與生產排程模型,減少營運對資深員工個人經驗的依賴。

不只把菜切好,乾燥加工尋找第二成長曲線

除了改善截切本業,宜展也開始發展乾燥加工。學校團膳在寒暑假面臨需求波動,生鮮蔬果則有保存期限短、價格易受產季影響等限制。林佑澤希望藉由乾燥技術延長農產品保存期限,開拓附加價值更高的加工業務。

不過,乾燥同樣有依賴經驗的問題。傳統做法是太乾就降低溫度、縮短時間,不夠乾就反向調整。每批原料的水分與成熟度不同,反覆試做不僅增加成本,也難以維持品質一致。「品質目標沒有設定的話,前面的製程參數就不知道怎麼調整。」林佑澤將過去研發車用面板的思維帶進農產加工:先決定產品希望達到的口感、含水率與水活性,再回頭檢視原料成熟度、截切厚度及乾燥參數等條件。

團隊進一步結合不同乾燥技術、自行改造設備,並接洽桃園的設備業者合作。林佑澤曾比較其他地區的設備,最後選擇設備構造、乾燥均勻度與可靠度較符合需求的桃園業者。宜展也持續累積製程參數,希望未來透過AI找出適合不同原料的乾燥曲線,減少反覆試做。

「我們主要還是要做代工,想要做一個功能性的原料平台。」林佑澤說,果乾目前更像是展示技術能力的產品,未來希望將服務延伸至辛香料、中藥材、太空食品、超級蔬菜及寵物食品等領域。現階段宜展主要營收仍來自蔬果截切本業,乾燥事業尚未形成主要收入。未來若能建立穩定的乾燥製程與代工能力,宜展便有機會從既有蔬果供應鏈,切入附加價值更高的食品原料市場。

從彰化走向桃園,驗證營運方法能否跨區複製

隨著加工流程逐步數位化,宜展也開始思考,這套管理方法能否帶到彰化以外的場域。

參與桃園市政府青年事務局天際線加速器及Meet桃園+後,宜展擴大與桃園產業生態系的連結。林佑澤提到,天際線協助邀集不同局處了解團隊需求,並提供資源媒合機會。宜展也開始與桃園市農會及在地農民合作,增加北部原料來源。這項合作不只拓展了供應來源,更成為宜展因應極端天候、穩定供貨的重要助力。林佑澤回憶,先前中南部連日降雨,蔬菜供應受到影響,宜展便從北部調度蔬菜,以不同產區互相支援,降低天候對供貨的衝擊。此外,團隊也透過天際線資源,獲得參與日本國際伴手禮設計競賽的輔導,並成功榮獲金賞獎肯定,除了展現產品的創新與設計實力,也為宜展拓展海外市場、提升國際能見度創造更多機會。

下一步,宜展規劃以桃園大溪作為第二個驗證場域,將彰化累積的資料、SOP與加工管理經驗,轉化為可複製、可優化的營運管理模式,帶到不同產地、供應鏈及人員條件下驗證。林佑澤指出,未來若要跨區域擴張,不可能每到一個新地方,就把原有團隊整批搬過去。因此,宜展希望將資深員工的實務經驗,轉化為標準化流程與數據模型,結合AI進行生產排程、資源配置及營運決策,讓新場域能依據當地條件快速調整,降低對特定人員經驗的依賴。

從彰化到桃園,宜展接下來要驗證的,是這套從傳統農產加工現場整理出來的管理方法,是能夠跨區域複製、快速部署並持續優化的農產加工營運系統。 長期目標是降低新場域的建置成本與管理複雜度,提升擴張效率,讓傳統農產加工業具備規模化發展的能力。

登入數位時代會員

開啟專屬自己的主題內容,

每日推播重點文章

閱讀會員專屬文章

請先登入數位時代會員

看更多獨享內容

請先登入數位時代會員

開啟收藏文章功能,

請先登入數位時代會員

開啟訂閱文章分類功能,

請先登入數位時代會員

我還不是會員, 註冊去!
追蹤我們
一次搞懂工業AI
© 2026 Business Next Media Corp. All Rights Reserved. 本網站內容未經允許,不得轉載。
106 台北市大安區光復南路102號9樓
