「這是地表最強編碼模型!」Claude Sonnet 4.5上線:更快更穩不加價,它是GPT‑5 Codex最大剋星?

重點一:Anthropic 發布 Claude Sonnet 4.5,稱其為迄今最強;可在長時程任務中連續執行超過 30 小時,並在多項基準測試領先同業。

重點二:Sonnet 4.5 在 SWE-bench Verified 取得 77.2%、在 OSWorld 取得 61.4%,超過 OpenAI 的 GPT-5 Codex 與 Google 的 Gemini 2.5 Pro;並強化電腦操作與代理能力。

重點三:Anthropic 同步推出 Claude Code 2.0 與 Claude Agent SDK,並為網頁與 App 新增程式執行、檔案建立與文件/試算表/簡報生成功能;API 價格延續 Sonnet 4。

Anthropic 推出中階旗艦模型 Claude Sonnet 4.5,官方稱其為「迄今最強」版本;能在複雜的多步長任務中「連續專注」超過 30 小時,同時在多項公開基準測試刷新成績,展現程式開發、電腦操作與推理計算的整體提升。

相較前代 Sonnet 4.0,4.5 在 OSWorld 電腦使用測試由 42.2% 大幅躍升至 61.4%,並於 SWE-bench Verified 取得 77.2%;整體表現超越 OpenAI 的 GPT-5 Codex 與 Google 旗下的 Gemini 2.5 Pro,凸顯其在實務開發與代理任務上的即戰力。

程式、電腦操作、多語知識⋯同步進化

Anthropic 指出,Claude Sonnet 4.5 的核心強項在於「可在真實環境中更穩定地完成長鏈任務」。雖然公司未披露 30 小時連續工作的具體任務內容,但強調其代理行為在長時間情境下維持一致性,減少過去常見的上下文遺失與錯誤累積。

就量化表現,該模型於 SWE-bench Verified 拿下 77.2%,在 OSWorld 取得 61.4% 並居於領先,分別高於 OpenAI 的 GPT-5 Codex 的 74.5% 與 Google 的 Gemini 2.5 Pro 的 67.2%。同時,在 AIME 2024(數學競賽基準)、MMMLU(14 種非英語科目知識)與 Vals AI Finance Agent(金融分析代理)等評測亦見進步,其中金融代理測試達 92%。

Claude Sonnet 4.5 基準測試
Sonnet 4.5 在 SWE-bench Verified 得分77.2%、OSWorld 61.4%,超過 OpenAI GPT-5 Codex 與 Google Gemini 2.5 Pro。
圖/ Anthropic

此外,Anthropic 表示已降低模型在「sycophancy(逢迎)」「deception(欺瞞)」「power-seeking(權力尋求)」與「鼓勵妄想傾向」等風險行為,回應外界對聊天機器人社會化使用的關注。

Claude Sonnet 4.5 更老實了
Anthropic指出,已降低模型在逢迎、欺瞞、權力尋求等AI風險行為。
圖/ Anthropic

根據《Ars Technica》報導,儘管業界對廠商自行公布的基準成績向來持審慎態度(可能受資料汙染或設計偏誤影響),Sonnet 4.5 仍相較 4.0 呈現實質躍進;並獲知名開發者 Simon Willison 初步肯定,稱其在程式能力上優於其近週常用的 GPT-5 Codex。

速度即智慧!Claude Sonnet 4.5 更快、更簡潔

Willison 引述 Cora(cora.computer)總經理 Kieran Klaassen 的說法指出,Claude Sonnet 4.5 在 Claude Code/App 中「體感快約 50%」。同樣的大型程式碼評審任務,Sonnet 4.5 約 2 分鐘完成,GPT-5 Codex 約 10 分鐘。在「速度也是智慧的一個維度」的前提下,更利於長時間配對工作。亦即, 能在大型上下文與多檔案間保持專注、不亂飄,並且更可引導、結果更一致、回覆更簡潔。

Willison 舉例,他將三份營運試算表交給模型,便能迅速生成可用的第三季投資人更新 Word 文件。至於 Klaassen 則指出,在 Cora(Every 的郵件管理工具)專案裡有一個程式錯誤,先用 Claude Opus 4.1 嘗試未能解決,但換成 Claude Sonnet 4.5 後約 20 分鐘就修復。

Willison 總結指出,若使用者以 Claude Code 為日常編程主力,Sonnet 4.5 是更快、更可靠、可引導性更優的新夥伴;但若是 GPT-5 Codex 擁護者,編程難題仍建議以 Codex 為先。若是新專案、vibe coding,或需要 Claude「勤勉+速度」組合的任務,就值得考慮 Sonnet 4.5。

用價格換市占!Claude Sonnet 4.5「加速不加價」

為配合模型升級,Anthropic 同步發布 Claude Code 2.0(命令列 AI 代理)與 Claude Agent SDK(代理開發套件),瞄準開發者打造客製化程式代理的需求。Claude Code 2.0 引入「checkpoint(檢查點)」以保存進度並可回滾,更新終端介面,並上線原生 VS Code 擴充;API 端亦新增「context editing(脈絡編輯)」與更佳的長任務記憶工具,改善長流程代理工作的穩定性。

在使用者端,Claude 網頁與 App 介面新增「程式碼執行」與「檔案建立」,並可在對話中直接產生試算表、投影片與文件;「Claude for Chrome」擴充則強化瀏覽器內的網站導航與表單/資料處理。

此外,Anthropic 推出為期五天的研究預覽「Imagine with Claude(與 Claude 想像)」供 Max 訂閱者體驗,展示模型在即時產生軟體上的潛力。

值得注意的是,Anthropic 以兩段式階梯定價包裝 Claude Sonnet 4.5。第一段針對標準 200K 上下文長度:輸入每百萬 token 3 美元、輸出 15 美元。

這個價位直接把同家前代旗艦 Opus 4.1(輸入 15 美元、輸出 75 美元)的成本拉低到約五分之一,形成「以中檔價格提供近旗艦能力」的攻勢,目標明確對準主流對手如 GPT‑5 等。

Claude Sonnet 4.5 API價格
Anthropic指出,對標準 200K 上下文長度:輸入每百萬 token $3、輸出 $15。
圖/ Anthropic

第二段則針對超長上下文(超過 200K):輸入每百萬 6 美元、輸出 22.5 美元。這是「超長加價、但仍維持性價比」的設計,讓需要長文脈的用例有合理成本,同時透過輸出端維持較高單價,以控制推理時間與算力消耗。

其策略核心是以「低輸入價」促進更多資料餵入與多步推理,並以輸出價差回收算力成本;配合「混合推理/擴展思考模式」,當開啟更長思考與高準確度輸出時,價格結構自然引導開發者優化 token 使用,避免不必要的長輸出。

簡單來說,這種定價策略的總體效果,是以極致性價比快速搶佔編程與 Agent 場景,讓開發者在可控成本下獲得高階能力,並對競品形成明顯的價格壓力。

延伸閱讀:因為AI,他成了身價1830億美元的CEO!Anthropic開發出最會寫程式的模型,為何又變AI頭號黑粉?

自掏腰包買書訓練AI合法嗎?Anthropic獲關鍵勝訴:「合理使用」原則是什麼?

資料來源:Ars Technica、Simon willison、01 Founder

本文初稿為AI編撰,整理.編輯/ 李先泰
關鍵字: #Anthropic #Claude
往下滑看下一篇文章
OpenAI 重磅講者親臨高雄|掌握前瞻 AI 與產業轉型關鍵趨勢

隨著 AI 工具逐漸普及,真正拉開差距的,已不只是技術或算力的強弱,是企業能否整理資料、重新設計流程,並把 AI 融合既有工作方式,持續轉化為營運價值。

Amazon Web Services(AWS)將於10月23日於高雄舉辦「2026 亞馬遜港都 AI 創新日」邀請 OpenAI 與製造、金融、交通、零售及運動育樂等領域的實務代表,從技術趨勢、資料治理、流程設計與組織轉型等面向,拆解 AI 落地前必須處理的現實問題,協助企業重新檢視自身的導入條件與下一步布局。

企業下一步,不只是再導入一套 AI 工具,而是讓 AI 進入日常營運

模型可以採購,系統可以建置,但資料是否整理到位、流程能否重新設計、組織是否清楚由誰負責,才是決定技術能否持續發揮價值的關鍵。

高雄近年推動數位轉型,同樣面對這項核心課題。亞灣周邊聚集扣件、石化、鋼鐵等傳統產業,場域複雜、既有系統眾多,正因如此,更能檢驗一套 AI 導入方法是否具備複製與擴大的條件。城市發展也從建置算力基礎,進一步走向讓技術真正進入產業與治理現場。

AWS 連續六年深耕高雄,今年以「雲騰智慧大南方 齊創 AI 好未來」為主軸,將討論重心從雲端與算力基礎,推進到應用全面升級,協助城市從「有 AI」走向「AI 有感」。

政府治理是否更即時、產業流程是否真正改變、市民與使用者能否感受到服務提升,才是「AI 有感」的具體檢驗。延續「高雄試點、全臺普及、雲端出海國際」的發展路徑,10月 23 日登場的亞馬遜港都 AI 創新日要談的不只是企業「有沒有 AI」,而是導入之後企業的真實改變。

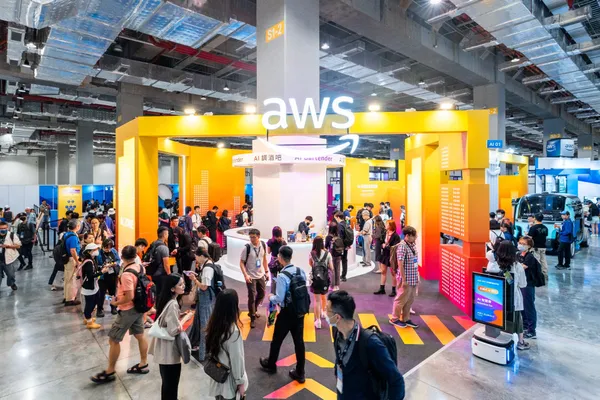
2025 亞馬遜港都 AI 創新日現場,資料照
圖/ AWS

OpenAI 重磅講者親臨高雄,從技術前沿看見企業的關鍵課題

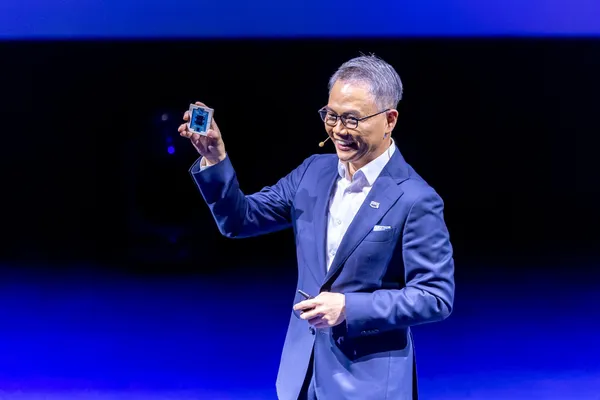
今年活動特別邀請 OpenAI 東南亞暨台灣合作夥伴總監 Mark Jeffrey,以「前瞻 AI 如何助力產業領袖開創新局」為題,分享在 AI 技術快速演進之下,企業應如何重新思考未來布局。

面對 AI 能力邊界持續擴張,哪些應用已具備規模化條件?哪些仍需要更完整的資料、治理與組織準備?這是正在規畫下一階段 AI 投資的企業必須先回答的關鍵課題。

上午議程將從資料、組織與金融三個面向,拆解 AI 落地前必須處理的現實問題。「數據為本,AI 啟航」先回到資料基礎:外部模型跑得再快,若企業自身的欄位定義、存取權限與資料品質尚未整理到位,技術仍難以轉化為可靠判斷。

「打造 AI-Ready 組織的關鍵布局」論壇則聚焦組織當責。AI 專案通常橫跨資訊、營運與管理部門,真正困難的不只是把系統建起來,而是由誰推動流程改造、由誰認列成果,以及當 AI 產出的判斷出現問題時,責任最後應由誰承擔。公部門、製造業與雲端服務業者如何從不同角色處理這些問題,對其他組織同樣具有參考價值。

金融創新論壇將討論 AI、虛擬資產與企業轉型。金融場域對資料安全、合規、風控與可追溯性的高度要求,也提醒企業:效率不能取代治理,AI 更不能成為責任模糊的理由。能否在高監管、高風險環境中建立清楚邊界,將直接影響 AI 應用能不能被長期採用。

2025 年活動論壇現場,資料照
圖/ AWS

從六種產業場景,看 AI 如何走進真實流程

真正具備參考價值的 AI 案例,不只要說明「做了什麼」,還要回答幾個更實際的問題:解決哪一段流程、使用哪些資料、在哪個節點交給 AI、誰負責最後判斷,又如何確認投入確實產生價值。

下午議程規劃橫跨智慧支付、製造、媒體科技、智慧交通、零售製造與運動育樂六種產業場景。每個場景面對的資料條件、即時要求與風險門檻都不相同。

產業場景 議程規劃與關鍵課題
智慧支付 藍新金流運用 AWS AI 自建智能 KYC 與交易監控;處理身份辨識、交易監控與風險判斷
製造 以語意層串接資料孤島,讓 AI Agent 正確理解分散在不同系統的資料
媒體科技 會說台語的 AI Agent:從醫院櫃台到第一線的落地實戰
零售製造 零售製造轉型;把技術接進實際營運與使用者體驗

這些差異進一步說明,AI 沒有一套可以直接複製到所有產業的標準答案。企業真正需要的,不只是更多案例,而是看見不同產業如何依資料條件、即時要求與風險門檻,把 AI 融入實際營運與使用者體驗。

現場同步打造「產業賦能走廊」,邀集超過 15 組雲端生態系夥伴設置展示攤位,聚焦智慧製造、金融科技與城市治理的真實痛點與解法。無論企業目前卡在技術、資料、治理,還是組織協作,不同問題點,都能找到對應的解方。

10 月 23 日,從智慧製造的產線優化、金融科技的風控升級,到運動產業的會員體驗創新,看 AI 如何從概念走進產業現場,成為百工百業轉型升級的實際動能。

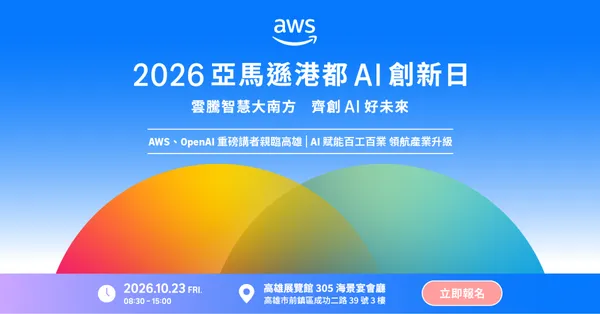
10/23高雄展覽館盛大舉行
圖/ AWS

「2026 亞馬遜港都 AI 創新日」,掌握 AI 賦能百工百業、領航產業升級的實務趨勢
立即報名

登入數位時代會員

開啟專屬自己的主題內容,

每日推播重點文章

閱讀會員專屬文章

請先登入數位時代會員

看更多獨享內容

請先登入數位時代會員

開啟收藏文章功能,

請先登入數位時代會員

開啟訂閱文章分類功能,

請先登入數位時代會員

我還不是會員, 註冊去!
追蹤我們
一次搞懂工業AI
© 2026 Business Next Media Corp. All Rights Reserved. 本網站內容未經允許,不得轉載。
106 台北市大安區光復南路102號9樓