在當前 AI 競爭圖譜中,效能提升往往與算力成本、推理延遲掛鉤。然而,Google Research 團隊最新的研究卻提出了一個反直覺的「低成本」方案:僅透過重複輸入指令(Prompt Repetition),即可在不增加輸出長度的前提下,顯著優化跨模型的效能表現。
要強調的是,這項技術不僅僅是「重複一遍」,它是對因果語言模型(Causal LLMs)注意力機制缺陷的一種技術性補償,為企業級 AI 部署提供了一條極高性價比的升級路徑。
因果語言模型的「單向注意力」瓶頸
為什麼「說兩次」就會對AI的生成結果有幫助?
這是因為當前主流 LLM 架構多為 Causal Language Model,其處理序列的底層邏輯存在一個物理限制:因果性遮罩(Causal Masking)。在模型處理過程中,第 N 個 Token 只能觀察到第 1 至 N-1 個 Token,無法預見「未來的資訊」。
不要慌!這邊所謂的「未來資訊」,主要是指**「輸入提示詞(Input Prompt)中尚未讀到的後半段內容」**。
假設提示詞結構: 「<問題> <文章背景>」。
那所謂的因果性遮罩,就是指AI模型讀到開頭的 「<問題>」 時,它在運算當下完全看不到後面還有 「<文章背景>」,因為模型在讀取提示詞時,跟人類一樣也是由左至右、一個字一個字讀的。這對模型理解問題造成了困難,因為它必須在缺乏背景資訊的情況下先處理「問題」。
這就是為什麼提示詞的順序會影響表現。如果您把問題放在最後,模型讀到問題時已經看過文章了;但如果把問題放在最前,模型就「看不到未來(後面的文章)」。無論是哪種順序,都還是讓AI的注意力維持單向。
提示詞重複如何破解「單向注意力」瓶頸?
根據這份報告的發現,所謂的「提示詞重複」(Prompt Repetition)操作非常直觀且簡單。報告中明確指出,這項技術的核心是將原本的輸入 「<提示詞>」 轉換為 「<提示詞><提示詞>」。操作原理如下:
調整後提示詞結構: 「<問題><文章背景> <問題><文章背景>」。
其效果就是,當模型讀到第二遍的開頭(即第二個 <問題>)時,原本屬於「未來」的 <文章背景>(在第一遍中),現在已經變成了「過去」的歷史資訊。
報告中提到,這種近乎土炮的方式之所以有用,是因為讓提示詞中的每一個 Token 都能夠「注意到(Attend to)」提示詞中的其他所有 Token,從而模擬出雙向注意力(Bidirectional Attention)的效果。
這種提示詞「說兩次」的招數,適用於哪些情境?
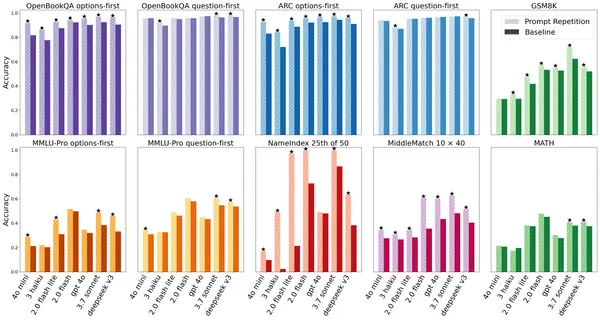
研究針對 Gemini 2.0、GPT-4o、Claude 3.7 及 DeepSeek V3 等 7 種模型進行測試,在 70 項基準測試中取得了 47 勝 0 敗 的驚人紀錄。
以下歸納出最適合使用此招數的兩大情境:
不要求模型推論時
這是最關鍵的判斷標準。如果您的應用場景不需要模型「一步步思考」(Chain of Thought, CoT),這招效果最好。
- 適用原因: 當模型不進行 CoT 推理時,它往往是一次性直出答案。報告顯示,在這種「非推理模式」下,提示詞重複在 70 個測試中贏了 47 次,且0 次失敗。
- 反之: 如果您已經使用了「Think step by step」等提示詞,重複輸入的效果會變成中性或僅些微提升(5 勝 1 敗 22 平),因為 CoT 本身就會讓模型在輸出時自我重複部分資訊,使得輸入端的重複變得多餘。
長文本中的「精確檢索」與「定位」
如果您的任務是要求模型在一段很長的文字中,找出某個特定的資訊,這招的效果最為驚人。
具體案例:
-
找名字(NameIndex): 例如給定 50 個名字,問「第 25 個名字是誰?」。在 Gemini 2.0 Flash-Lite 的測試中,準確率從原本的 21.33% 飆升至 97.33%。
-
找夾心(MiddleMatch): 例如給定一長串名單,問「誰位於某甲和某乙的中間?」。這類任務需要模型精確定位前後關係,重複提示詞帶來的增益非常強勁。
-
建議: 對於這類較困難的查找任務,報告甚至建議可以考慮重複 2 次(即總共輸入 3 遍,Repetition x3),效果可能比標準的重複 1 次更好。
重複提示詞不是萬靈丹?
根據這份報告的實驗結果與文獻回顧,雖然「提示詞重複」在許多情況下能顯著提升效能,但在以下 2種特定情境中,此方法可能無效:
已經啟用「推論模式」或思維鏈 (CoT) 時
這是最主要的不適用情境。如果您在提示詞中加入了「一步步思考」(Think step by step)或是使用了像 OpenAI o1 、Gemini 3 這類內建強大推理能力的模型,重複提示詞的效果會大打折扣。
- 效果判定: 結果呈現中性至僅些微正面(實驗中為 5 勝 1 敗 22 平),不再具有壓倒性優勢,。
- 原因: 報告指出,當模型進行推理(Reasoning)時,它們通常會在輸出的過程中自己重複提示詞的關鍵部分。既然模型已經會在輸出端「自我重複」,那麼在輸入端手動重複就顯得多餘且沒必要了。
提示詞已經「極度」過長
雖然報告強調「重複提示詞」通常不影響生成延遲,但在極端情況下會有物理限制。例如原本的提示詞已經非常接近模型的 Context Window(上下文視窗)上限,再重複一次可能會導致超出長度限制而無法執行。
報告在附錄中提到,對於 Anthropic 的模型(Claude Haiku 和 Sonnet),當處理非常長的請求(例如 NameIndex 任務搭配 3 次重複)時,延遲確實會增加。這可能是因為「預填充(Prefill)」階段的運算時間變長了。
操作要點:真的重複貼上就好
若原本的提示詞包含了「背景資訊(Context)」與「問題(Question)」,操作上真的只需要將這整段內容完整複製並貼上一次即可。
通用公式:
最終提示詞 = [完整原始提示詞] + [完整原始提示詞]
舉例而言,一段沒有重複的原始提示詞如下:
這裡有一份名單:Dale Lopez, Peter Sanchez, Allen Harris...(略)。 請問名單上的第 25 個名字是誰?
那麼,符合報告定義的「重複提示詞」如下:
這裡有一份名單:Dale Lopez, Peter Sanchez, Allen Harris...(略)。 請問名單上的第 25 個名字是誰? 這裡有一份名單:Dale Lopez, Peter Sanchez, Allen Harris...(略)。 請問名單上的第 25 個名字是誰?
值得注意的是,重複的範圍必須是整個提示詞。如果只是單純重複「問題」部分(例如只重複問句而不重複文章背景),在相關研究中顯示並無效果。
結語:懂推論的模型就別用這招了
總結來說,報告測試並驗證了以下模型適用於「重複提示詞」的技巧,可以發現幾乎都是API成本較低的非推論模型。
- Google: Gemini 2.0 Flash, Gemini 2.0 Flash Lite
- OpenAI: GPT-4o, GPT-4o-mini
- Anthropic: Claude 3 Haiku, Claude 3.7 Sonnet
- DeepSeek: Deepseek V3
要注意的是,若您原本使用的就是 Gemini 3 這類推論模型,「重複提示詞」的效果可能就不會這麼顯著。
最後,Prompt Repetition 可說是 LLM 應用層的一次「優雅補救」。它餘解決了因果模型先天的結構短板。在追求 AGI 的路上,回歸底層邏輯的簡單方案,往往才是最具商業穿透力的破局點。
資料來源:arxiv
本文初稿為AI編撰,整理.編輯/ 李先泰