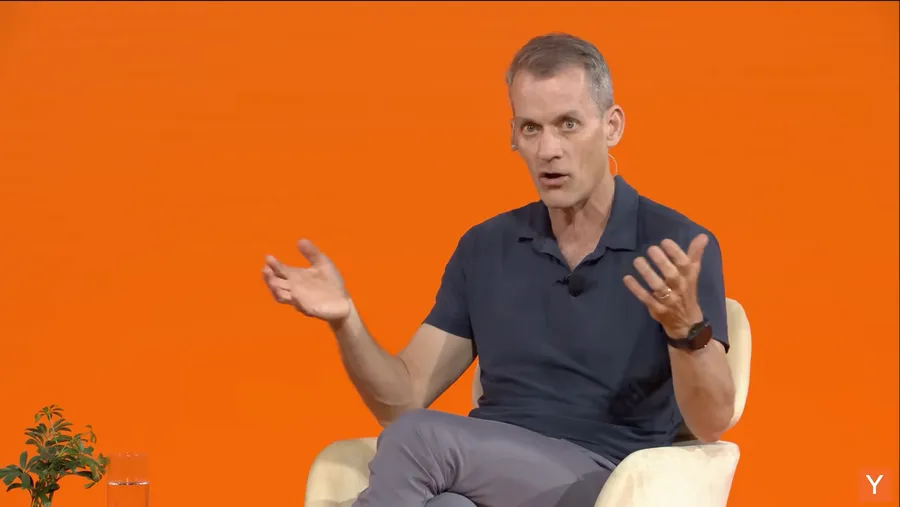

近期,Google 前首席科學家迪恩(Jeff Dean,首圖)帶領3名頂尖 AI 研究者離開 Google,成立一家用AI自動化研發過程的新創公司Discovery Loop。
隨著打造新一代前沿大型語言模型(frontier LLM)所需的投資攀升,對許多產業而言,針對特定領域打造垂直AI模型(Vertical AI)會是更可行的選擇,同時能帶來更低的推論成本,以及更高的資安與隱私保障。
深挖「成功率<1%題材」拉開差距
在YC Startup School 2026座談中,迪恩提到,新創的產品切入點,最好選在前沿模型目前仍不擅長、成功率低於1%的問題上。如此一來,垂直產業AI與通用前沿模型之間,才能拉開一道更寬的護城河。
這個建議來自通用LLM的快速改進。很多領域的特定模型,在2年前勝過當時的通用大語言模型,但現在已被新發表的通用大語言模型超越。
然而,雖然不少大型企業已陸續宣布與Anthropic、OpenAI等前沿模型業者的合作案,但企業心中同時也存有疑慮:自家的專有知識與技能,會不會被吸納進前沿LLM之中,日積月累之下,專有知識終究外流。
開放權重(open weight)模型的能力也持續增強,與頂尖前沿模型的差距愈拉愈近。以Kimi(由月之暗面開發)、Qwen(由阿里巴巴開發)與 Nemotron(由輝達開發)等模型為例,它們在程式撰寫與其他通用LLM任務上的表現不斷提升,已經足以成為閉源前沿模型有效而合理的替代方案。
這類模型還多了一項優勢:可以在地端(on-premises)部署,並以產業自有的專有資料在本地進行微調。對特定產業與特定地區而言,往往存在高度集中的知識與經驗累積,這些正是可以被挖掘出來、用以打造專屬垂直AI的養分。
打造垂直產業LLM需要大量的高品質數據、產業專家的標註和判斷、數據及模型的管理和訓練平台,和可彈性調度的大量算力。好在已有許多公司,如亞馬遜、微軟、Google Cloud Platform等超大規模雲端服務商(hyperscalers)可提供相應的支持。同時也有新創,如剛與美國能源部合作Genesis Mission(創世任務)的Arcee AI,同時發表新的開源模型並提供客製化的服務。
3條路築護城河:自建、結盟、開放社群
建立垂直產業專用模型所需要的資源和經驗可透過以下數種方式獲取:
一、企業自建。例如國際律師事務所Kirkland & Ellis在 2026 年 5 月宣布,將投入5億美元自建內部AI平台,打造專屬法律業務的AI;另一家公司LILA Sciences則正在打造一套「科學超級智慧」,把科學推理與機器人系統整合起來,加速假說的驗證,並已在材料科學到生物化學等多項領域做出實例。
對財力充足、又握有專有資料與洞察來源的大型企業來說,這是確保新的AI能力轉化為競爭優勢的理想路徑。
二、產業聯盟。例如台灣近期啟動的金融大語言模型(FinLLM)專案,由 16 家金融機構共同投入資料與資源,並參與所建模型的評測。
同樣地,台灣開源基金會(TAIONE Open Source Foundation)也宣布,將協助發展供台灣產業使用的開放權重與開源 LLM。輝達則聯合多家公司成立Nemotron聯盟,共同開發開放權重模型,促成將問世的 Nemotron 4 模型家族。
三、開放社群。當資料與專業高度分散、任何單一組織或機構都難以獨大時,這是最理想的模式。
醫學影像分析就是絕佳的例子:模型要在實務上表現良好,就必須取得來自大量不同醫院、不同地區的資料,最終的模型才具備足夠的穩健性,去應付真實世界中千變萬化的資料樣態。
即使模型本身維持專有,開放社群式的評測基準(benchmark)仍能在推動特定領域AI能力的進展上扮演要角。這類例子不少,如「Humanity's Last Exam(人類的最後考試)」評測前沿模型的推理與問題解決能力;柏克萊大學推出的新評測「Agents' Last Exam(代理人的最後考試)」,則是測試AI代理能否使用人類專家實際會用的軟體,完成具有經濟價值的任務。
目前這個評測,有許多種類的前沿模型成功率仍為0,正是迪恩所建議的情況,是開發垂直產業專用AI的好機會。
從亞洲企業的強項來看,半導體設計與製造、IC設計都是既有的領域優勢。此外,還有AI基礎建設所需的散熱、發電與電力配送、網路通訊,以及材料科學設計等。這些都是產業橫跨多個領域、發展並強化垂直AI能力的機會。
而在資安領域,業者長年累積的資料同樣可以餵入垂直AI模型,提升模型在這些特定領域的表現。隨著開放權重模型的能力持續加強,大型企業和新創都可在它們擅長的領域開發出領先世界的AI能力。
責任編輯:陳祈安