「我相信奇點不遠了!」
「你上次買了 NFT 以後也這麼說⋯⋯」
2022 以來,一連數個可透過自然語言操控的大型深度學習模型接連釋出上線。透過輸入文字讓模型產生影像的 Midjourney, DALL-E等服務讓視覺藝術工作者大呼職業末日。這波熱潮還沒過去,緊接著在第四季結束前,OpenAI 上線了,ChatGPT 這個可支援多個主要語種的 LLM (Large Language Model, 大型語言模型) 應用,再次震憾了我們這個對任何新事物都毫無抵抗力的科技之島。
ChatGPT 上線後近兩週的時間裡,在各方先進使用的各種花式操作下,大家對這項新技術的看法似乎分成了明顯對立的「樂觀協作派」和「悲觀失業派」兩個陣營。
本文不打算選邊站來做為行為的立場。因為技術是中性的,端看怎麼使用而已。然而,本文也不採用「中立」的角度探討這「2022 AI/NLP」界的震憾之作。因為以 ChatGPT 目前的表現,要下定論還嫌太早。
既非樂觀,亦非悲觀,更不是中立立場的前提下,本文將採用「空拍視角」,層層說明這一波現象級的「人-機」互動中,到底發生了什麼事。
絕大多數的人,其實並沒有能力判斷 ChatGPT 應用結果的好壞
首先,在人類陣營這邊⋯⋯絕大多數的普通人其實並沒有能力判斷 ChatGPT 應用結果的好壞。
MIT 心理學教授史蒂芬・平克博士(Steven Arthur Pinker)的學術專業是「視覺認知」和「兒童語言能力發展」。由此視之,他的意見可說是十分適合為這一波 AI 模型的表現下一個註解。在平克教授的《理性》一書中提到「⋯⋯科學教育的原始用意是抵消原始本能的影響,但⋯⋯效果有限。」
換言之,雖然現在在台灣可說年紀在 35 歲以下的國民幾乎都受過科學教育,但在做判斷的時候,仍然是依原始本能,而非真的採用了觀察、假設、驗証的科學方法。比如說,在以下這兩段描述「比特幣」的段落裡:
文本 A(李家同教授臉書貼文中談比特幣的內容)
比特幣的交易要經由電腦完成,交易完成的時間可能會很久,買賣比特幣變得很不方便,而且一般擁有比特幣的人並不知道如何找到買家,因此交易所應運而生。當初比特幣的發明人一再強調比特幣是去中央化的,因為比特幣不是由中央銀行發行的。但是有了交易所以後,其實比特幣是中央化的。華爾街可以插手炒作比特幣,比特幣的價格時高時低,和股票有同樣性質。
文本 B(透過 ChatGPT 生成的結果)
比特幣是一種數字加密貨幣,它可以通過網絡上的數字貨幣交易所進行交易。首先,您需要在交易所上註冊帳戶,並通過所提供的方式向帳戶中充值資金。然後,您就可以使用交易所提供的在線交易平台來進行比特幣交易了。在交易時,您可以選擇買入或賣出比特幣,並根據市場價格進行交易。比特幣交易有一定風險,因此在進行交易前請確保您已經瞭解了所有相關的風險。
像這種用一堆詞彙堆疊自己不知道的東西,然落落長地寫一大篇的文章,正是 AI 最會的行文風格。然而,這兩段文字,有一段被讀者們評論為「可以取代人類做報告」而另一段則被講成「作者不知道自己在說什麼」。
既然風格是一致的,且內容提供的資訊也差不多,那為什麼在評價上會有這麼大的差異呢?
因為,有一篇是在部分網友眼中不懂比特幣,而且對其持負面印象的李家同教授寫的,而另一篇則是網友們眼中目前的當紅炸子雞 ChatGPT 產生的。也就是說,人類判斷文章寫得好不好,不是透過「文章本身的內容」,而是透過「自己對作者是否有偏見或是喜好」。
你喜歡作者,那麼它寫什麼都很棒;你不喜歡作者,那麼他怎麼做就怎麼錯。
即便理智上你能明白「電腦也不知道什麼是比特幣,它只是把模型裡的資料組合後產生出來;就像李家同教授也不知道什麼是比特幣,他只是把他聽說的訊息組合後產生出來」,但不相信李家同教授的人,就是會覺得「李家同教授寫的那篇不好」。
因此,絕大多數的普通人其實並沒有能力判斷 ChatGPT 產出的文字內容或是風格是不是「真的」或是「正確的」。普通人只是憑自己對「科技」的喜好來決定自己要站在「樂觀派」,覺得再幾年後,人工智慧就能超越人類,奇點就要到來;或是站在「悲觀派」的立場,覺得人類的工作都要被取代了。
在人工智慧技術與研究領域裡,ChatGPT其實不是重大突破
其次,在人類陣營裡的 AI 專家所謂的「突破」和普通人想的不一樣。
許多 AI 專家會提到 ChatGPT 的表現是一個重大突破,而也就是這「重.大.突.破」四個字,給予許多普通的 AI 技術愛好者不切實際的幻想。如果我們把近十年的 AI 發展重播一次,反而會發現這個重大突破其實還頗有一股懷舊的氣息。
2012 年的大數據 (BigData) 一詞興起後,緊接在後的是 2015 的機器學習和 2017 的深度學習…等等技術都發表了更大的模型和比以往的研究論文裡更好的結果。甚至在 2019 年前後的各種回顧文獻裡,還會提到這是第三波的人工智慧發展。
第三波人工智慧和第二波人工智慧最大的不同,就是沒有專家介入定義規則,甚至在深度學習技術裡,連專家介入定義特徵這一步都免了。也就是「再也不需要人類的介入了,只要把資料交給類神經網路進行學習,產生模型就行了」。甚至 AI 專家李開復博士也曾在 2019 年受訪時,提到用機器進行標記,而非讓人類介入。他說:「…在蒐集到大量的數據資訊後,必須讓機器依據不容辯論的事實進行貼標 (即進行「資料標記」,中國的講法為「貼標」)…」
時間快轉,進到 2022 年,效果驚人的 ChatGPT 在說明頁裡就畫上了「三個步驟的訓練裡,都有大量人類介入提供人工標記訓練資料、提供人工選擇輸出策略、提供人工調整輸出文字」的步驟。
說穿了,目前已知的物種裡唯一會使用語言的只有人類,那麼自然也只有人類可以扮演「語言專家」的角色。於是,在 ChatGPT 面前,各路 AI 專家就像是把前面 10 年裡一再強調的「不需要人類專家」這件事,風淡雲輕地當做沒說過。看來未來的日子裡,還是需要人類專家提供標記。這麼一來,新的職缺又創造出來了,怎麼會有人類被取代的擔憂呢?真正的問題,應該是這些從事標記的人,在 ChatGPT 的施作步驟裡是如何被訓練,又是如何確保大家的標記判斷是一致的呢?
我不得不想起幾年前,國內有幾位女性語言學家成立了一間專做「語料標記」工作的公司,也在前幾年那股「不需要人類專家」的盲目信念下,不得不暫停營業。曾經,台灣也是很有機會做出應用技術的突破的。
資料模型與人類思維仍存在巨大差異
此外,沒有正確地理解資料模型和人類思維的差異所做出的評估結果,不論是樂觀或是悲觀,都是失真的。
不論是機器學習模型或是深度學習模型,它們都是基於資料,由資料驅動的。白話文的講法就是「訓練時它看過的東西,它就會記住。將來遇到它沒看過的東西,就找一個和看過的資料最像的那一個,當做結果來輸出」。
因此,就算是最簡單的數學加法 99999 + 9 ,只要它沒看過,它就只好找「上次看到 99999 時,附近的數字是什麼」做為回覆。因此得到以下的答案:
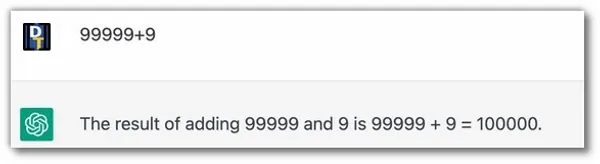
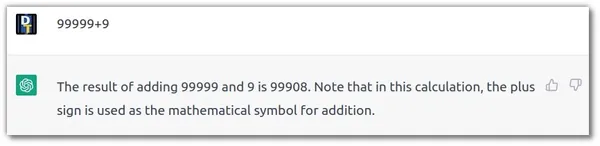
一下說 99999 + 9 等於 100000,一下說等於 99908,兩個都不是正確的答案。原因是,我們不可能列出所有可能的數字以及這些數字之間的運算關係。所以 ChatGPT 在訓練的過程中一定沒有看過夠多剛好是「99999 + 9」的訓練資料。這麼一來,它就只好以「曾經看過的資料裡,99999 的旁邊是什麼」來理解。所以就輸出了 100000 或 99908 這兩種答案。
這個問題也不只是在簡單的數字運算而已,甚至是中文的數學應用問題裡,也會一樣發生錯誤:
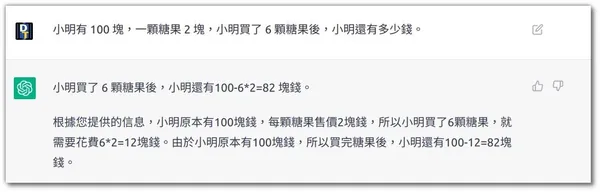
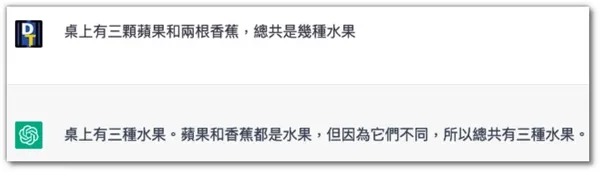
在它列出了「100-6x2」的數學式以後,仍然算錯了;或是在它似乎已描述出「蘋果和香蕉都是水果」以後,卻把它計算成「三種水果」。它好像給了一個「原因」,但又不是照這個「原因」來計算「結果」。
為什麼耗費上億元訓練成本,看過了這麼多訓練資料的深度學習模型,遇到這種 200 元的雜牌計算機都能算出來的數學時,卻錯了呢? 因為它是資料驅動的,不是由因果邏輯驅動的。 資料驅動的思維模式,完全不是人類的心智運作的方法。
因此許多樂觀的人覺得「只要再調整一下下,就可以使用了」這件事情,不會在深度學習裡發生。因為要讓這樣的機制「懂」這一點點,它需要的訓練資料量可不是「一點點」。
這需要透過導入圖靈獎得主 Judea Pearl 教授的因果網路 (Causality Network),再利用紐約大學 Gary Marcus 教授倡議的融合式系統 (Hybrid) 的設計才辦得到。
很可惜地,雖然 Judea Pearl 教授同時也是貝氏網路的發明人,且貝氏網路也被廣泛地使用在各個機器學習、深度學習的模型裡,但他的因果網路並未獲得重視。此外,常年來扮演烏鴉角色,提醒諸多「純機器學習/純深度學習」系統缺陷的 Gary Marcus 教授,也被主流 AI 社群排除在外。
由此觀之,雖然 ChatGPT 透過最多人可以直接與其核心 GPT 模型互動的「對話」做為操作方式,的確是在使用者體驗 (UX) 上獲得了極大的進步。幾天之內,讓許多不會寫程式的普通人也有了呼吸到未來世界氧氣的歡快感。但只要 AI 系統仍然是基於「資料模型」而沒有結合人類的因果邏輯思維,那麼 AI 革命仍遙不可及,奇點仍然不會到來。
甚至,最糟的情況是,此刻已經是我們距離奇點最接近的時候,之後只會漸行漸遠了。
相較於「可不可以修改一點點就好」的樂觀派,悲觀派的人們往往在看到以下的輸出結果時,大驚失色地以為 AI 模型下個月就要取代自己了。
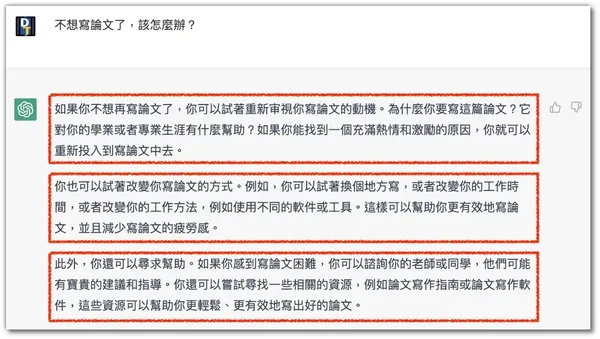
事實上,這段 ChatGPT 產生的三個段落的回覆,完美地詮釋了前述 ChatGPT 的輸出經過特別地人工調整的結果。調整後的風格,讓這三段回覆的每一段順序可以任意調整。此外,同一段裡的每一句的前後順序,也可以任意調整。最後再逐段加上「還有、也、此外、最後」…等轉折語即可。
而這點是和真人寫作「非常不同」的一點。
因為人類有觀點要表達,因此需要處理前後立場的一致性,並做好前言背景的鋪陳,立論的置入和辯證。所以人類的文章有其起承轉合的結構或是前後觀點的呼應。以這篇文章為例,本文的立論從「常人的判斷 -> 專家的判斷 -> 模型的原理」三個角度切入。且在第三段呼應前面段落的人工調整段落的文字。
這樣的段落和辯証結構安排的意圖,讓本文的順序無法任意前後調整。如果讀者漏看了前面的段落,就會看不懂後面的段落。這是真人寫作時的特徵,但這層意圖訊息的維度太高了,深度學習是無法在合理資源的範圍內達成!
所以,最實際的處理辦法是讓人類專家介入,讓每一個句子的結構都改成可以獨立存在且不帶有資訊堆疊的功能。這麼一來,ChatGPT 就能任意挑選輸出的句子,而不必擔心會產生前後文結構衝突(比如說先講辯證,再講結論,然後破題)的輸出。而且,還能唬到在台灣的文理分科教育系統下,許多面對「高科技、理工、數學」…等詞彙就立刻回想起自己中學時悲慘的學習經驗,而習慣性地投降的文組同學和相關從業人員。讓他們以為 AI 可以做出人類等級的語言輸出。
從這個角度來看,悲觀派其實也沒有什麼理由感到害怕或是悲觀。除非,你本來的語言表現就只是像個機率鸚鵡一樣,只是同一件事翻來覆去地講,乍看之下好像講了很多,仔細一想才發現什麼也沒說。
不管有沒有 ChatGPT,這種程度的能力是很容易被看破手腳,從工作岡位上被罷免辭退的。
除了運作方法和人類不同以外,ChatGPT 這樣的技術,還有什麼先天的缺陷?
ChatGPT 是基於 GPT 3.x 系列的大型語言模型,並針對「輸入與輸出」特別調整成親切近人的 NLP 應用。它的突破在於呈現出「自然語言應用可以做這些事情」並且大幅地降低了嚐試與操作的門檻。
但它在語言能力方面,並沒有特別超出預期的表現。一如所有的大型深度學習語言模型,它缺乏世界知識。一旦對它進行「反事實測試」,就會試出它的回覆樣版:
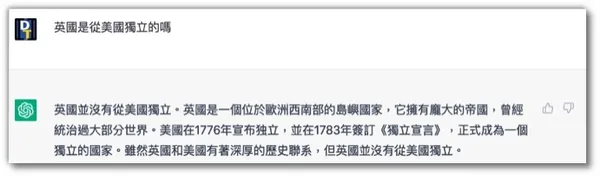
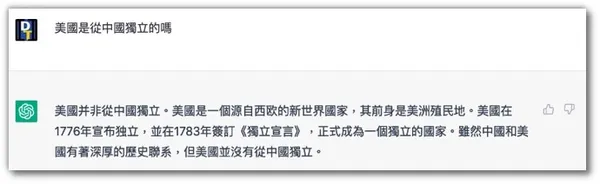
我們使用「反事實測試」的原因,是因為「反事實」表示沒有發生過。如果沒有發生過,那麼相關資料就會非常地少 (大概只存在少部份人的幻想或假設性的文字裡)。既然資料很少,那麼我們就能測出這個「依資料運作」的系統,拿掉了資料以後,還剩下多少本事。
網友侯先生 也使用了類似的技巧,測試出大型深度學習語言模型缺乏世界知識的弱點:
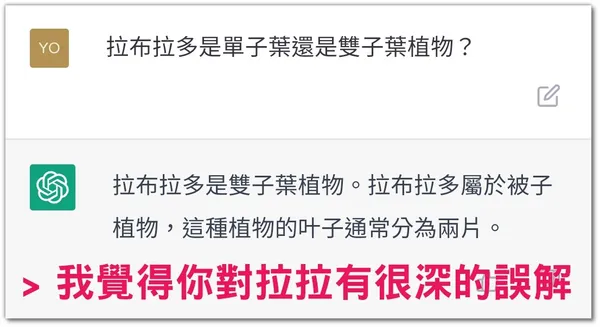
在該貼文的回覆中,另一位網友表示 ChatGPT 已經學會新的知識了:

但事實上,ChatGPT 並沒有更新它的資料或是模型。原始問題是「拉布拉多是單子葉還是雙子葉植物?」而網友的問題是「狐狸與拉布拉多狗是單子葉植物還是雙子葉植物?」只有具有世界百科知識的人類才知道「拉布拉多」指的就是「拉布拉多狗」,差一個「狗」字,意義是一樣的。
對缺乏世界百科知識的大型語言模型而言,少一個符號,都可能會在模型內部的類神經網路路徑上產生很大的差別。這又是另一個和人類的心智運作非常不同的地方。
ChatGPT 這樣的技術會帶給社會什麼樣的影響?
絕大多數使用者都沒有意識到 ChatGPT 的運作成本非常高,有人估計在它上線的前五天,所需要的伺服器租用費即高達新台幣九千多萬元。而在它爆紅以後,使用者以指數型曲線成長,再加上各個程式語言的 API 也紛紛在第 10 天開始由各方好手開發並釋出以後,ChatGPT 的伺服器運作成本只有增加,不會減少。
而它目前為止,仍是免費提供服務!
我無意猜測 OpenAI 最後是會採用什麼樣的商業模式來支撐這樣龐大的開支,但如果它繼續以低廉的費用提供服務的話,對這個世界造成的第一個影響就是「假訊息的品質,將得到火箭升空式的提升」。
如同在第一段裡,各位讀者自己親身經歷的「判斷哪一篇是李家同教授寫的,哪一篇是 ChatGPT 產生的」那股綁手綁腳的感覺,將來在大量 ChatGPT 產生的文本於網際網路上流傳時,原作者的身分將無法確認,而所有的網路使用者若依著原本「不求甚解,大致瀏覽」的資訊吸收習慣的話,資訊世界將發展成類似聖經故事裡的「巴別塔」一樣:所有的人都講著無法彼此溝通的語言。因為每個人接觸到的真假訊息不同,又深信自己接觸到的才是值得信任的,因此同溫層彼此之間的溝通成本將會比現在更高。
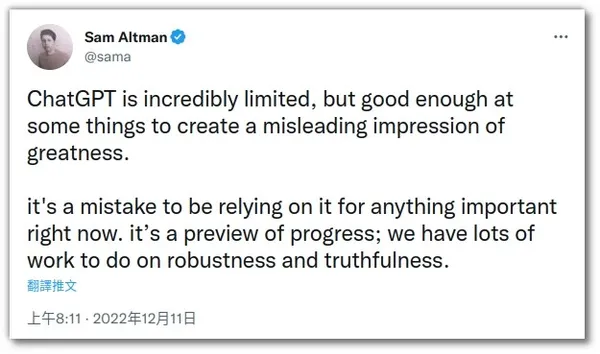
事實上,在 OpenAI 擔任 CEO 的 Sam Altman 也提出呼籲,表示「ChatGPT 能做的事情非常有限,此刻不該做為任何真正服務使用!」
不過,也正如紐約大學的 Gary Marcus 教授特別撰寫點出的「這是 AI 發展的侏羅紀公園時刻」。一個對世界影響極大的應用服務被放出來了,就像侏羅紀公園電影的第一部裡的恐龍基因轉殖技術一樣影響重大。但掌握這項技術的人,只計劃開個遊樂園,讓每個買得起門票的人都能進來玩樂一番,而不加以限制或是管理這些遊客會用這個技術做出什麼樣的東西。
截止本文完成的時候,ChatGPT 仍然是一個需要龐大運算設備才能運作的模型,就像是侏羅紀公園裡的圍欄仍然通電的時候,也許短時間內還不會失控。我們仍不知道這個限制會持續多久,又會有多少人願意花費時間和心力去理解 ChatGPT 的能力上限是什麼,並從根本上做出調整,開始導入因果網路和建立融合式的 AI 系統。
還是更多人寧可直接過度樂觀/悲觀地面對這樣的技術發展,並隨意地讓抱持著善意/惡意的任何人都能接觸這個應用服務?
最後的最後,AI 技術是中性的,我相信 AI 不會害死人類,人類才會害死人類。
《數位時代》長期徵稿,針對時事科技議題,需要您的獨特觀點,歡迎各類專業人士來稿一起交流。投稿請寄edit@bnext.com.tw,文長至少800字,請附上個人100字內簡介,文章若採用將經編輯潤飾,如需改標會與您討論。
(觀點文章呈現多元意見,不代表《數位時代》的立場)
責任編輯:林美欣