

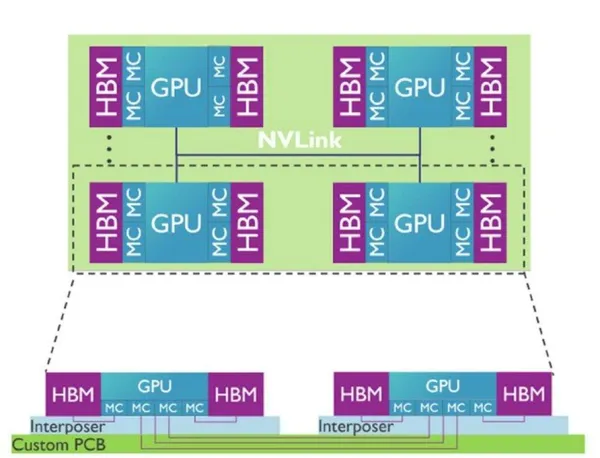
現在打開一張AI晶片的封裝示意圖,常會看到GPU位於中央,數顆HBM排列在周圍。但這個大家已經熟悉的配置,未來可能出現很大的變化。
imec(比利時全球微電子研發中心)執行長范登納米勒(Patrick Vandenameele)在8月31日ITF Taiwan 2026發表演講,描繪一種下一代AI運算架構:HBM不再固定服務特定GPU,而是集中成一個可以被多顆運算晶片共同存取的記憶體池,再透過光互連,把不同XPU與記憶體高速串接起來。
這個改變背後,是AI運算架構正在變得愈來愈複雜。當AI從單一大型模型走向多代理系統,不同AI代理可能分散在不同運算單元執行,也需要更頻繁地交換資料、讀取記憶體。未來AI晶片要解決的問題,是如何讓愈來愈多運算單元快速存取彼此需要的資料。
HBM為何要「搬家」?多代理AI正在改變運算架構
目前主流高階AI晶片大量採用2.5D封裝,把GPU與多組HBM整合在同一個中介層(interposer)上,HBM通常配置在GPU周圍。這是目前AI晶片2.5D封裝常見的配置,主要目的就是縮短資料移動距離,提供AI運算所需的高記憶體頻寬。
但范登納米勒認為,接下來AI工作負載本身正在改變。過去大型語言模型主要由一套大型模型完成任務,如今則開始走向多代理AI,也就是讓多個各自負責不同工作的AI代理彼此合作。未來這些代理未必全部跑在相同硬體上,有些可能使用GPU,有些則由CPU或其他專用AI加速器負責。
這也會改變硬體需要處理的資料流。范登納米勒指出,部分研究顯示,特定多代理AI系統所需的運算負載,可能達到現代大型語言模型的150倍。除了運算需求提高,這些代理還需要保存及更新自己的狀態,並持續與其他代理交換資訊,因此對記憶體容量與晶片間連接能力都提出更高要求。
如果每一組HBM仍然固定跟著特定GPU,當不同XPU需要頻繁交換、讀取彼此資料時,就可能產生大量跨晶片資料搬移。對imec來說,下一代AI硬體因此不能只思考怎麼替單一GPU增加更多HBM,也需要重新設計整套運算與記憶體架構。
不讓HBM只服務一顆GPU,imec想打造「共享記憶體池」
按照范登納米勒展示的架構,大型中介層上會放置多顆不同功能的XPU,而HBM則從系統邊緣移往更中央的位置,形成一個可以被不同XPU共同使用的記憶體池。簡單來說,HBM的角色可能從某一顆GPU旁邊的高速記憶體,逐漸轉變成整個AI運算系統可以共同調度的資源。
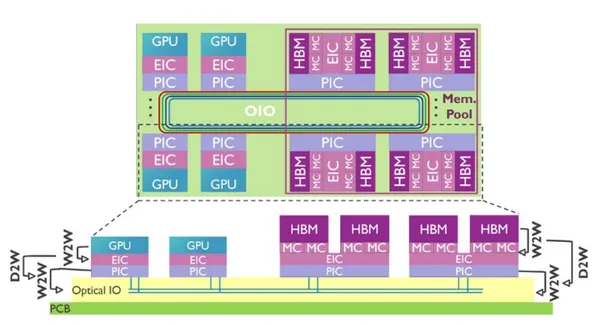
當不同AI代理分別跑在不同XPU上,每顆運算晶片就不必只依賴自己身旁的一組記憶體,而可以存取共享的記憶體資源。范登納米勒在演講中表示,在imec設想的架構下,每顆XPU距離其他XPU或HBM最多只需要經過兩個連接節點。
不過,記憶體一旦從特定GPU旁邊拆出來,另一個問題也隨即出現,也就是資料要怎麼在大量XPU與HBM之間高速移動。這也是他認為光互連需要進一步往晶片封裝內部發展的原因。
HBM變成共享池後,光互連得一路進到中介層
目前光通訊已經廣泛用在資料中心較長距離的資料傳輸,但運算晶片、HBM之間的短距離連接,仍大量依靠電訊號。隨著AI系統納入愈來愈多XPU,imec認為電互連將逐漸受到功耗、頻寬與布線空間限制,因此光互連技術也必須持續往運算晶片靠近。
范登納米勒將這套架構形容成一條「光學高速公路(optical highway)」。相鄰的XPU或記憶體仍可以透過電互連交換資料,但距離較遠時,就改走光互連,如此才能在大型中介層上串起大量運算與記憶體資源,同時降低資料搬移帶來的功耗壓力。
這也解釋了為什麼HBM與矽光子會同時出現在imec的下一代AI架構裡。當AI運算需要更多不同種類的XPU共同工作,記憶體就可能從個別GPU旁的資源,逐漸變成更容易被整個系統存取的記憶體池;記憶體一旦共享,晶片之間的資料交換量也會跟著增加,進一步推動光互連從資料中心網路往封裝內部延伸。
不只有imec,SK海力士也畫出「XPU池+記憶體池」
值得注意的是,這並不只是imec單方面描繪的遠期架構。SK海力士8月20日公布一套長期CPO技術藍圖,同樣把未來AI系統分成「XPU池」與「記憶體池」,並利用光子中介層(photonic interposer),直接以光連接運算資源與記憶體資源。SK海力士指出,這種架構可以讓多顆AI加速器共享大型記憶體池,提高系統調度記憶體與搬移資料的彈性。
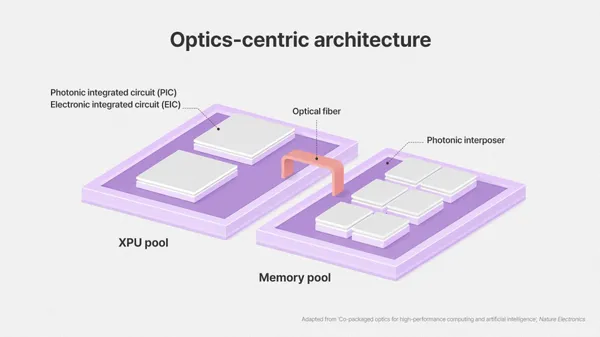
imec與SK海力士提出的技術路線並不完全相同,也都還屬於長期架構構想,但兩者指向相近的變化。隨著AI系統規模持續放大,產業思考的單位正在從「一顆GPU配多少HBM」,逐漸往整個運算系統如何共同使用運算、記憶體與互連資源移動。
HBM競賽因此可能不再只有堆疊層數、容量與頻寬。隨著AI運算架構改變,這些高速記憶體要放在哪裡,以及如何讓更多AI晶片共同存取,也可能成為下一階段需要解決的問題。
延伸閱讀:AI晶片概念股有哪些?台積電之外,聯發科、世芯⋯26檔受惠股全拆解
AI將引發失業潮?黃仁勳反駁比爾蓋茲:AI 會是史無前例的工作創造者
