Spotify算準音樂喜好,讓用戶掏錢訂閱!官方卻願意教你如何「反演算法」?

作為煎餅果子聖地,天津人評價最高的煎餅店,一定不是人們趨之若鶩的網紅店,而是「我家樓下那家」。

人們對於音樂的喜好,和天津人對煎餅果子的愛有異曲同工之處,好友熱情分享的音樂,通常會被你歸為「垃圾」。隨著卡帶、CD、MP3逐漸被行動網路取代,音樂平台最終承載起滿足人們音樂品味的重任。

社群媒體上歷久不衰的兩個問題,一個是為什麼「隨機」推薦並不是真的「隨機」,另一個就是為什麼音樂平台推薦的音樂都這麼「垃圾」。如果有機會,大概所有人最想做的事情就是去面對面問一下音樂平台的工程師,自己到底怎麼才能「調教」好這個App,讓它推薦更多自己喜歡的音樂。

以用戶數最多的音樂平台Spotify為例,他們最近開發出了一種新的演算法——偏好轉化模型(Preference Transition Model,PTM),想要預測,一年後的你會聽什麼音樂。

當我們只看見自己喜歡的內容

抖音、微博、淘寶、YouTube、Spotify,這些平台的演算法想盡辦法猜測我們的喜好,然後把它們覺得我們會喜歡的內容推給我們。

有些時候,這些算法確實猜得很準,我們看到的都是喜歡的內容。但從另一方面來說,我們只看了自己喜歡的內容。

recommended-laptop-1400.png
圖/ O'Reilly

網路活動家伊萊·帕里瑟(Eli Pariser)在2011年的時候提出了他著名的「過濾氣泡」(Filter Bubble)理論:算法會根據用戶的地址、歷史點擊、過往搜索等用戶相關資訊猜測用戶喜好。這個過程中,那些與用戶意見不相同的訊息就被過濾掉了。長期下來,用戶就會無法接觸新的想法和訊息,逐漸隔絕在自己的意識形態泡沫中。

在處理過濾氣泡的問題上,Spotify一直因為精準的演算法而為人稱道。不只是讓用戶在自己熟悉的內容裡打轉,它總能幫用戶發現那些新鮮的歌曲。而恰好,這些歌曲還很討人喜歡。

揭開Spotify「演算法黑箱」

「每週發現」(Discovery Weekly)是Spotify在2015年7月的王牌欄目。每週一,Spotiy就會向用戶推薦30首完全沒聽過的歌曲。同時,它又總能帶來非常好的用戶體驗。截至2020年6月25日,每週發現總共被播放了23億小時,大約是26.65萬年,比人類文明存在的時間還長。

Spotify是怎麼做到這一切的?當然還是演算法。

Spotify主要使用了三種推薦機制——協同過濾算法(Collaborative Filtering Model)、卷積神經網絡(Convolutional Neural Networks)和自然語言分析(Natural Language Processing)。

Netflix是最早使用協同過濾算法來推薦內容的平台。在Netflix大獲成功之後,這種算法就變得越來越流行。簡單來說,它會根據用戶之間的相似性而不是內容的相似性來推薦新事物。

對Spotify來說,擺在它面前的是一個巨大的數據庫,裡面裝滿了用戶聽過內容的歷史。協同過濾算法會根據用戶A聽過的歌曲,找到也喜歡這些歌的另一個用戶B,然後向A推薦只有B聽過的歌曲。

「同喜QRS,則嘗試一下P 和T」|Erik Bernhardsson,前Spotify 員工.pn
「同樣喜歡QRS,則嘗試一下P和T」
圖/ Erik Bernhardsson

但協同過濾算法的一大缺點就是所謂的「冷啟動」,只有掌握足夠多的數據,協同過濾算法才能發揮作用。如果用戶是一個還沒有聽過多少歌的新用戶,或者資料夾裡有一首非常冷門的歌曲,協同過濾算法就無法精準匹配。

這就引入了另一種算法——自然語言處理。Word2Vec常被用在自然語言處理中,它可以將我們日常的對話編碼成數學關係——向量。

Spotify做了和Word2Vec相似的工作。它會抓取網路上描述音樂、歌曲或者歌手的詞語,通過算法分配給它們不同的權重。這個權重,一定程度上代表了人們用這個詞來描述音樂的概率。通過自然語言處理,Spotify就能確定那兩首歌彼此是相似的,從而解決冷啟動問題。即使是冷門的歌曲或歌手,也能得到推薦。

Spotify的第三種方式是卷積神經網。

在前面兩種算法的幫助下,Spotify已經獲得了足夠多的數據,但卷積神經網絡可以進一步提高音樂推薦的準確性。

卷積神經網絡會分析歌曲的特徵,包括拍子、音調、模式、節奏、強弱度等。通過閱讀這些歌曲的特徵,Spotify就可以根據用戶的收聽歷史了解它們之間的相似性,匹配用戶的喜好。

Daft Punk 的歌曲「環遊世界」的數據分析圖|The Echo Nest.png
Daft Punk 的歌曲「環遊世界」的數據分析圖。
圖/ The Echo Nest

正是通過這三種算法,Spotify像魔法般猜準了用戶的喜好,打造出了千人千面的Discover Weekly。

但即使Spotify已經成為了世界上最流行的流行音樂播放軟體,即使世界上最聰明的人在這裡構建出了無比精巧的算法,過濾氣泡的「詛咒」依舊存在。

於是,Spotify,又多做了一步。

但是,人是會變的呀!

2021年4月,Spotify聯合多倫多大學發布了一篇論文《下一步去哪兒?一種用戶偏好的動態模型》(Where To Next?A Dynamic Model of User Preferences)。

他們在4年間(2016年至2020年)分析了10萬名用戶的收聽數據,來觀察用戶的消費分佈變化。他們發現,隨著時間的變化,用戶的消費習慣也在發生變化。先前的算法擅長捕捉用戶的靜態喜好,但當面對長時間的跨度時,卻無法捕捉用戶動態的喜好變化。對於Spotify的長期用戶來說,他們依舊可能困在過濾氣泡中。

1623210690986
這是2016年第一季對比隨後每個季度的總消費變化直方圖。顏色越深,對比的時間跨度就越長。比如,最左邊的淺色曲線是2016年第一季和2016年第二季的對比;最右邊的深色曲線是2016年第一季和2020年第二季的對比。隨著時間的增加,變化也越來越明顯。
圖/ Spotify

Spotify同時也發現,當免費用戶消費的音樂種類越多時,他們越有可能轉化為付費用戶。也就是說,用戶聽到的音樂類型越多,他們越喜歡Spotify。

那麼該如何知道,一個人未來的音樂口味呢?

Spotify給出了一個新的演算法——偏好轉化模型(Prefenrence Transition Model,PTM)。

在這張偏好轉化模型的草圖中,我們可以大致窺見PTM的工作原理。

7246c166656817813f57d118d4424884.png
圖/ Spotify

我們現在有個用戶1號,根據歷史,可以知道他喜歡聽靈魂樂(Soul)。我們想知道,他以後會不會喜歡新世紀音樂(New Age)和布魯斯(Blues)。

轉換矩陣A是PTM的核心,將上述的數據輸入A,就會得到一個預測的結果。可以看到,新世紀音樂的數值(0.4)和靈魂樂(0.5)非常接近,那用戶1將來很有可能會喜歡上新世紀音樂。

當然,這只是一個最簡單的模型演示,實際情況要比這複雜得多。Spotify總共歸納了4000種音樂流派。而在Spotify的數據庫中,還有有3.56億個這樣的「用戶1號」。

2d8145f225cf3013c642011ede2f1fdd.png
PTM 的核心算法:指數加權移動平均分佈和泊鬆多項式兩級分佈。
圖/ Spotify
與之前的算法相比,PTM 在各項測試中都得到了最好成績|Spotify.png
與之前的算法相比,PTM 在各項測試中都得到了最好成績。
圖/ Spotify

除了預測性能,PTM的另一大特點就是可以直觀地解釋從一種音樂是如何轉換到另一種音樂的。假定我們現在有兩個音樂流派a和b,PTM就可以提供用戶在聽完a之後轉換到b的概率。這就解釋了兩個問題:

  1. a到b,哪條路徑是最短的?
  2. 如果用戶聽了a,那麼他接下來最有可能播放哪個流派?

回答這兩個問題,大大提高了PTM的效率和預測準確性。

這是一張偏好轉化的示意圖,顯示了初始流派(綠色)到目標流派(紅色)的最短路徑|Spotify.png
這是一張偏好轉化的示意圖,顯示了初始流派(綠色)到目標流派(紅色)的最短路徑。
圖/ Spotify

如何「馴服」演算法

看起來,Spotify已經做得很好了。但再聰明的演算法,都可能時不時抽一下風。畢竟,人確實很複雜,沒有人可以像你自己一樣了解自己。

Spotify官方也給出了一些建議,希望幫助你更好地「馴服」他們的演算法。

  • 給你喜歡的歌曲點個❤️。
  • 如果你不喜歡一首歌,在30秒之前跳過它。30s是個關鍵節點,如果在這之前跳過一首歌,相當於演算法在內部給它點了👎。
  • 聽聽新的歌手和他們的音樂。這樣演算法就可以更好地學習你的行為模式。
  • 提供你的年齡和位置訊息——要是你不介意的話。Spotify會根據用戶的年齡和地理位置推薦不同的音樂類型。
  • 如果你不想Spotify注意到你的行為,可以使用「私密模式」。
  • 最後,保持耐心。算法在設計中會忽略新的收聽行為中一些迅速的、突然出現的峰值,因為許多人會分享他們的Spotify登錄信息。因此新的收聽活動可能不會立刻導致你的播放列表變化。

本文授權轉載自:極客公園

責任編輯:郭昱彣、錢玉紘
關鍵字: #Spotify #演算法
往下滑看下一篇文章
AI讓軟體開發更快,誰來接住「上線之後」?諾德資訊以Production as a Service補上最後一哩

2026台灣設計展於9月24日至10月11日在桃園登場,以「桃園流」為主題,結合千塘之鄉的水文地景、國門之都的航空與物流優勢、多元族群文化匯流,以及 AI 科技應用,展現城市運轉的動態美學。

其中,為提供民眾不同於以往的互動體驗,AIoT 智慧感知大數據平台服務商棋苓(Chylyng)推出全展區 AI 穿戴互動體驗「FLOW CHECK」。參觀者配戴主辦單位提供的智慧手環後,可沿著展場動線於不同站點進行互動。即使多人同時參與,每位參觀者仍可依照不同的路徑、選擇與互動節奏完成體驗;系統並依據互動過程與結果,即時生成專屬的 Flowmomo 數位卡牌,讓參觀者儲存並帶走屬於自己的展覽體驗紀錄。

看似簡單的手環互動,背後其實是一套整合穿戴裝置、即時感測、場域互動、資料處理與雲端服務的完整系統。尤其在大型公開展覽環境中,不僅必須因應大量參觀者於短時間內同時使用,也必須確保從手環感測、站點互動、資料傳輸到最終結果產出的每一個環節,都能維持即時且穩定的服務品質。

棋苓以自主開發的 Eleplo AIoT Platform 為技術核心,整合穿戴裝置、感測設備、人員與資產定位,以及即時事件與資料管理,並負責建構 FLOW CHECK 的手環互動邏輯、站點應用、卡牌生成及參觀者操作介面。

專業分工合作:諾德資訊坐鎮後端,撐住大型公開展覽的服務韌性

為了讓系統從開發與測試環境順利進入大型公開場域,並進一步提升正式服務的可用性、資安與系統韌性,諾德資訊與棋苓採取專業分工合作。棋苓聚焦於 AIoT 平台、穿戴應用及使用者體驗;諾德資訊則負責後端基礎架構、正式環境部署、壓力測試、高可用性驗證,以及服務上線後的系統與流量監控。

由於展場現地部署時間僅有兩天,雙方將大量驗證工作提前至開展前完成。諾德資訊於正式開展前約一個月即建置專用測試環境,讓棋苓的應用服務提早與正式營運架構整合,並進行壓力測試、高可用性驗證及異常情境測試,使原本必須於現場進行的系統驗證工作大幅提前完成。

諾德資訊業務開發經理邱柏瑞表示:「FLOW CHECK 的挑戰在於大量參觀者可能集中於同一時段使用手環,因此除了確保服務穩定之外,也必須辨識進入系統的流量究竟來自真人使用者、合法自動化程式、AI Bot 或惡意攻擊,並透過即時監控及早發現異常。」為此,諾德資訊導入 IntelliFend Bot Management,協助辨識真人使用者、合法自動化及異常機器人流量,並於展覽公開服務期間透過遠端監控,持續掌握主機、資料庫、應用服務及外部流量狀態。

此外,為驗證系統在大型展覽情境下的承載能力,正式展出前,諾德資訊亦協助棋苓進行大規模壓力測試,模擬最高約 3 萬人同時使用的流量情境,提前觀察系統資源使用狀況、服務反應與可能的效能臨界點,並據此進行相關調校。

透過棋苓在 AIoT、智慧穿戴與互動應用上的技術能力,以及諾德資訊在正式營運環境、資安、壓力測試與維運監控上的經驗,雙方在展覽正式開放前,即完成從應用層到基礎架構的完整驗證,讓 FLOW CHECK 能夠在大型公開場域中穩定提供即時的 AI 穿戴互動體驗。

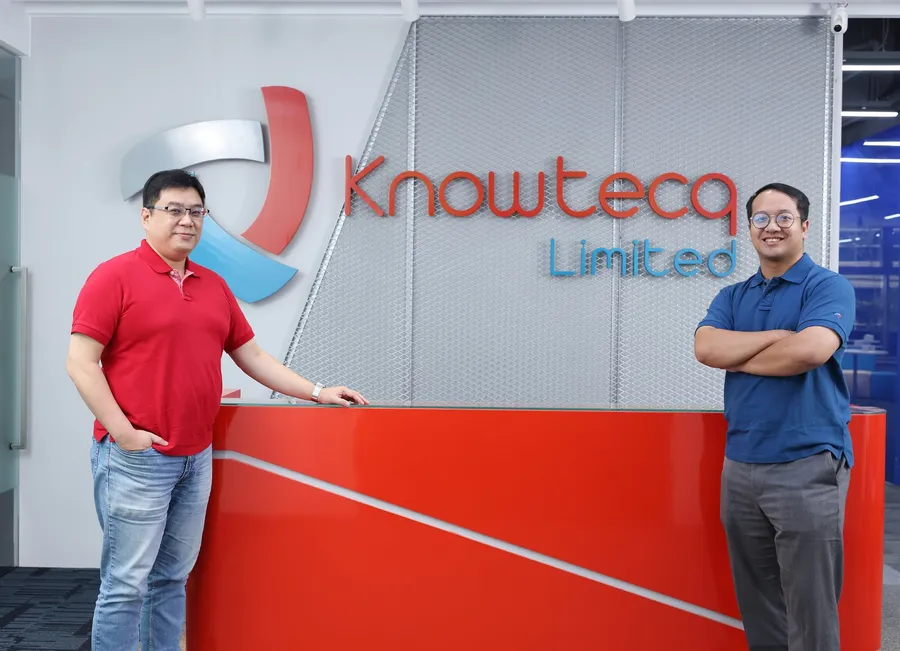
諾德資訊
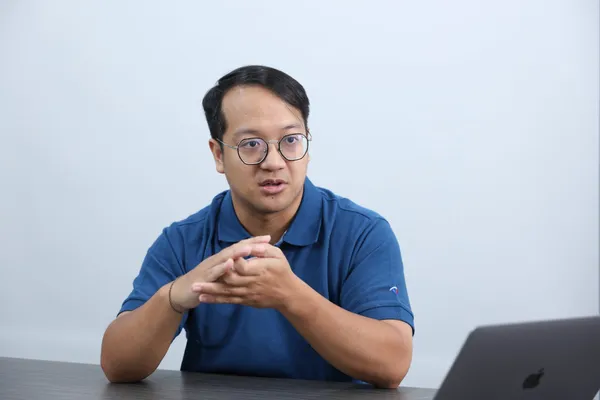
諾德資訊業務開發經理邱柏瑞表示,FLOW CHECK展前模擬約3萬人同時在線情境,並即時辨識流量來自真人、Bot、AI或惡意攻擊,提前掌握系統臨界值。
圖/ 數位時代

AI加速開發腳步,但也增加「上線」考驗

從生成式AI到代理式AI,軟體開發速度快速提升,過去需要長時間才能完成的產品原型(Prototype)與概念性驗證(PoC)專案,現在可以很快完成驗證,讓軟體商有更多時間跟資源投入客戶需求、產品創意與使用體驗。

但是,從PoC走到Production,面對的是完全不同的考驗。
諾德資訊技術長張家榮解釋,進入正式環境(Production)後,軟體服務必須面對真實使用者的流量、不同客戶的IT環境、計算資源擴充、資料庫負載、網路連線、資安攻擊,以及服務異常時的切換與處理,就算在壓力測試時表現正常的系統,也可能在Production的時候出現問題。

更值得特別注意的是,AI不只讓開發者更快,也讓攻擊者發現漏洞的速度加快;過去,服務上線後還有時間慢慢觀察、修正,現在,服務一上線,可能很快就遭到掃描甚至攻擊。

也因如此,軟體商、系統整合商選擇基礎架構夥伴的條件開始改變,從過去關注功能與價格轉向:產品能不能順利上線?出了問題誰來處理?面對流量變化與資安風險,服務能不能持續運作?

張家榮表示:「諾德資訊可以提供從公有雲、私有雲、地端、邊緣運算、主機代管、網路,到維運與監控等服務,讓軟體夥伴可以將資源集中在應用與客戶需求,無須擔憂Production議題。」

諾德資訊
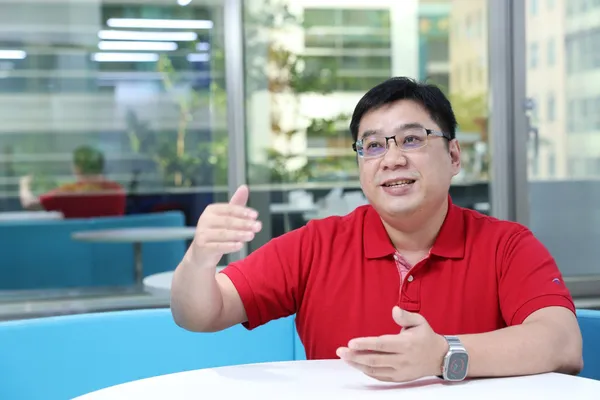
諾德資訊技術長張家榮指出,公司可提供從公有雲、私有雲、地端、邊緣運算、主機代管到維運監控的完整服務,讓軟體夥伴無須擔憂Production議題。
圖/ 數位時代

不僅提供資源,諾德資訊將Production變成一項服務

而這也是諾德資訊會提出「Production as a Service」的原因:不是在提供另一種雲端或主機服務,而是將軟體從開發走向正式營運所需的Production流程,轉化成可以被專業分工、驗證與持續維運的一項服務。

「Production as a Service不是單純把主機或雲端資源租給客戶,而是共同檢視這套軟體能不能順利上線與正常營運。」邱柏瑞表示。

實際做法包括,在上線前協助檢視架構,建立與正式環境相近的測試環境,確認系統正常狀態、最大承載量與資源需求,並驗證高可用性、資安、備援及服務切換機制;上線後則持續監看服務狀態、容量與流量,及早發現異常並處理。

諾德資訊之所以有這樣的服務能力,可以歸結為三點:

第一,長期累積的基礎架構與維運經驗,目前,諾德資訊同時服務的客戶數近30家,應用情境涵蓋IoT、購物平台、遊戲、音樂等不同類型的軟體服務。

第二,諾德資訊將每一個客戶遇到的問題與解決方案收攏至知識庫,讓團隊成員可以快速處理、借鏡,滿足客戶需求。

第三,依循ITIL的維運精神,並具備ISO 27001等資安相關認證,將服務流程、操作紀錄、備份、監控與異常處理等機制內化到服務之中。

這也是諾德資訊與單純提供雲端、IDC或主機代管服務的業者之間的最大差異:交付的不僅是基礎設施,而是讓服務持續運作的能力。面對客戶同時使用公有雲、私有雲、地端與邊緣運算環境,諾德資訊另以 MQloud 提供統一管理,把網路、防火牆、流量、監控與帳務收進同一套平台,降低跨環境營運的複雜度。

「軟體商負責開發,就像晶片設計公司;諾德資訊則負責協助完成測試、製程調整與正式生產,讓產品真正走向市場,希望成為『軟體界的台積電』。」張家榮如是說道。

展望未來,諾德資訊將持續深化 Production as a Service,成為軟體公司從上線到長期營運的夥伴。自構想階段起即與軟體商共同討論架構,於測試階段協助驗證,於準備上市時承接正式環境,上線後則持續守住流量、資安與服務韌性。軟體開發者與 SaaS 業者可將資源集中於產品與客戶,完整基礎架構與 24×7 維運則由諾德資訊端到端承接。

登入數位時代會員

開啟專屬自己的主題內容,

每日推播重點文章

閱讀會員專屬文章

請先登入數位時代會員

看更多獨享內容

請先登入數位時代會員

開啟收藏文章功能,

請先登入數位時代會員

開啟訂閱文章分類功能,

請先登入數位時代會員

我還不是會員, 註冊去!
追蹤我們
一次搞懂工業AI
© 2026 Business Next Media Corp. All Rights Reserved. 本網站內容未經允許,不得轉載。
106 台北市大安區光復南路102號9樓