
為什麼問 AI 同樣問題,答案每次都不同?是因為 AI 有意識嗎?
OpenAI 前技術長 Mira Murati 領軍的 Thinking Machines Lab 最新論文帶來了重要的突破。
相信每個和 AI 聊過天的人都有過這樣的經驗:你問了 ChatGPT 或其他大型語言模型 (LLM) 一個問題,得到了一個答案。出於好奇或為了驗證,你把一模一樣的問題,原封不動地再問一次,卻得到了另一個不完全相同、甚至截然不同的答案。
這到底是怎麼回事?難道 AI 真的有「自由意志」,每次都會有不同的「想法」嗎?
一般來說,我們會得到的解釋是 AI 具有「隨機性 (Stochasticity)」,就像我們擲骰子一樣,為了讓回答更多元、更有創意,它在選擇下一個字詞時會加入一點隨機的成分。這也是為什麼在許多 AI 工具的進階設定中,你可以看到一個叫做「溫度 (Temperature)」的參數:
當你把溫度設定為 0,理論上就是要求 AI 關掉所有的隨機性,永遠選擇那個「機率最高」的字詞,讓它的回答變得完全可預測、完全確定。
但詭異的是,許多工程師和研究人員都發現,即使你把溫度降到 0,AI 的回答還是會捉摸不定,時不時給你一些驚喜(或驚嚇)。即使你在自己的電腦上,用開源的模型和軟體,這個問題依然存在。
這就像是你有一台號稱絕對精準的計算機,但 1+1 有時候會等於 2,有時候卻等於 2.00000000001。對於需要精準、可靠、可複製結果的科學研究和許多商業應用來說,這是一個巨大的麻煩。
而這篇由 Thinking Machines Lab 發表的論文《擊敗 LLM 推理中的不確定性 (Defeating Nondeterminism in LLM Inference)》,深入探討了這個問題,找到了隱藏在幕後的真正元兇。
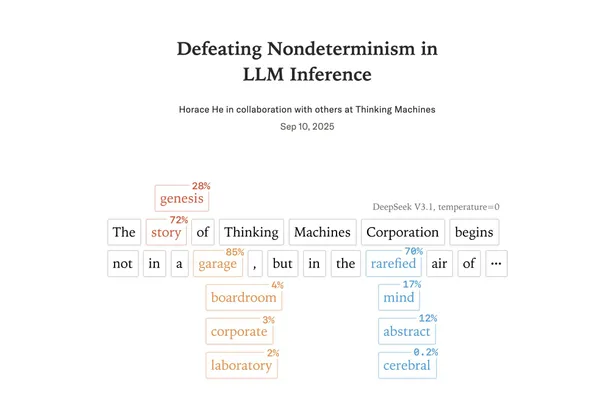
不過在揭曉答案之前,我得先大白話分享兩個電腦科學長久存在的老問題(或說現象),大家會比較好理解。
電腦老問題一:因為精度損失,導致最終結果出現微小差異
第一個是電腦天生的「差不多先生」問題,這叫做浮點數非結合律 (Floating-point Non-associativity)。(拜託你看到這個名詞先不要左轉中離!)
這聽起來很專業,但概念其實很簡單。我們先忘掉電腦,回想一下小學數學:(a+b)+c 是不是永遠等於 a+(b+c)?答案是肯定的,這叫做「結合律」。
但在電腦的世界裡,這個定律不一定成立。
為什麼?因為電腦儲存數字的方式跟我們人類不一樣。為了能同時表示極大和極小的數字,電腦採用了一種叫做「浮點數」的格式,你可以把它想像成一種「科學記號法」。它只會記住最重要的那幾個數字(稱為「尾數」),以及這個數字有多大或多小(稱為「指數」)。
這帶來一個問題: 精度是有限的 。
我舉個例子會更好懂:
假設你的尺只能精確到公分。現在要你測量「台北 101 的高度」加上「一張 A4 紙的厚度」。當你先把 A4 紙的厚度(約 0.01 公分)加到台北 101 的高度(約 50,800 公分)上時,因為你的尺精度不夠,這個微小的厚度很可能直接被「四捨五入」忽略掉了,結果還是 50,800 公分。
但如果你先計算兩張 A4 紙的厚度相加,再把結果加到 101 的高度上,情況可能就不同了。這就是浮點數運算的「非結合律」: 計算的順序不同,可能會因為精度損失而導致最終結果出現微小的差異 。
電腦老問題二:「平行運算」讓計算順序呈現隨機結果
第二個老問題是 GPU 的「七手八腳」、平行運算 (Concurrency) 的問題。
現在的 AI 模型運算,都依賴一種叫做 GPU (圖形處理器) 的晶片。GPU 的最大特色就是擁有成千上萬個微小的計算核心,可以同時處理大量的計算任務,就像有上千個工人同時在工廠裡工作一樣。
過去大家普遍認為,當這上千個工人同時計算,並要把結果匯報到同一個地方時(例如,把一萬個數字加總),誰先算完、誰後算完的順序是無法預測的。A 工人可能這次先回報,下次 B 工人搶先了。
結合前面提到的「差不多先生」問題,既然計算順序會影響結果,而 GPU 的計算順序又是隨機的,那麼 AI 每次的輸出結果都有一點點不同,似乎就合情合理了。這就是流傳已久的「平行運算 + 浮點數」假說。
然而,這篇論文告訴我們:這個假說,雖然不能說全錯,但它並沒有抓到問題的核心。事實上,在現代 LLM 的推理(也就是生成答案)過程中,大部分的運算都被設計成可以避免這種混亂的「先來後到」問題。單一的運算步驟,其實是相當穩定的。
那麼,如果單一步驟是穩定的,那不確定性到底是從哪裡來的?
原來真正的元兇是在於「公車班次」的問題 (缺乏批次不變性 Batch Invariance)。(拜託再忍一下,不要左轉中離!)
論文指出的真正元兇,是一個更隱蔽、也更有趣的概念,我稱之為 「公車班次」問題 。
想像一下,你是一位使用者,你對 AI 的一次提問,就像一個要去某個目的地的「乘客」。AI 伺服器就是「公車總站」。
為了提升效率,公車總站(AI 伺服器)不會每來一個乘客就發一班車。它會把差不多時間要出發的乘客集合起來,坐滿一輛公車再一起出發。這一車的乘客,在 AI 的世界裡就叫做一個「批次 (Batch)」。
現在,問題來了:
- 尖峰時刻: 當下有 100 位使用者(乘客)同時向 AI 提問,伺服器可能會派出一台「雙層巴士」(大批次),一次把 100 個問題一起處理。
- 離峰時刻: 如果當下只有你一位使用者(乘客),伺服器可能只會派出一台「小巴」(小批次),只處理你一個人的問題。
從你這位乘客的角度來看,你根本無法預測你這次搭上的是雙層巴士還是小巴。這完全取決於你送出問題的那一刻,伺服器有多忙碌。
而論文發現的驚人真相是: 你搭乘的「公車類型」(批次大小),會影響你「旅途的風景」(計算結果)!
這是因為,為了達到極致的運算效率,GPU 針對不同大小的批次,會自動選用不同的內部演算法(在論文中稱為 kernels)。處理 100 人大批次的演算法,跟處理 1 人小批次的演算法,其內部的計算順序是不同的。
於是,謎底揭曉了:
- 你送出了一個問題。
- AI 伺服器根據現在的忙碌程度,決定要把你的問題跟其他 N 個問題打包成一個「批次」。這個 N 是不確定的。
- GPU 根據這個批次的大小,選擇了對應的最佳演算法。
- 不同的演算法,意味著不同的計算順序。
- 不同的計算順序,觸發了前面提到的「浮點數差不多先生」問題,導致了微小的數值差異 。
- 這個微小的差異,在一層又一層的神經網路中被放大 ,最終可能導致在某個關鍵字詞的選擇上,從「紐約市 (New York City)」變成了「紐約皇后區 (Queens, New York)」。
所以,不確定性的根源,並非來自於單次運算的隨機性,而是來自於整個系統處理工作負載方式的「不確定性」。你的答案之所以會變,是因為在你不知道的情況下,有其他人「跟你搭了同一班車」,而這改變了司機(GPU)開車的方式。
那有解決方案嗎?既然找到了問題,解決方案當然也就呼之欲出了:無論乘客有多少,永遠都開同一款標準型號的公車!
這就是論文提出的核心解法: 「批次不變性 (Batch Invariance)」 。研究人員重新設計了 LLM 中三個最關鍵的運算環節: RMSNorm (一種標準化處理) 、 矩陣乘法 (Matrix Multiplication) 和 注意力機制 (Attention) 。
這個方法的核心想法是,強制讓 GPU 無論批次大小是多少,都必須使用同一套固定的計算策略和順序。
-
對於 RMSNorm 和矩陣乘法: 這相對單純。他們設計了一種策略,即使在乘客很少(批次很小)的情況下,也堅持使用為大批次設計的、雖然有點「殺雞用牛刀」但計算路徑固定的方法。這會犧牲一點點效能,但換來了絕對的確定性。從論文的圖表來看,這種效能損失大約在 20% 左右,在可接受範圍內。
-
對於注意力機制: 這就複雜多了,因為它還涉及到 AI 如何處理長篇對話的「記憶」(KV Cache)。研究人員必須確保,無論一個長句子是被一次性處理,還是分段處理,其最終的計算結果都必須分毫不差。他們採用了一種「固定分割尺寸 (fixed split-size)」的策略,確保了無論處理的文本片段長短如何,底層的計算模塊大小永遠一致,於是就可以保證了結果穩定。
實驗結果非常驚人。在使用標準的 AI 模型對「告訴我關於理查・費曼的事」這個問題生成 1,000 次回答時,即使溫度設定為 0,也產生了 80 種不同的答案版本。但在換上了他們改造過的「批次不變」核心後,1,000 次的回答,每一次都一模一樣,達成了真正的確定性。
那麼,確定性為何如此重要?
你可能會問,AI 有點隨機性不是更有趣嗎?為什麼要花這麼大力氣去消除它?
原因在於,對於許多嚴肅的應用場景,「可複製性」是科學和工程的基礎。
-
科學研究: 如果 AI 是一個科學發現的工具,研究者必須確保他們的實驗結果是可以被他人重現的。如果 AI 每次都給出不同的答案,那麼奠基於 AI 的科學研究就成了胡說八道。
-
AI 安全與除錯: 當 AI 犯錯時,工程師需要能夠穩定地重現這個錯誤,才能定位問題並修復它。如果錯誤時而出現、時而消失,除錯將會成為一場噩夢。
-
高風險應用: 在醫療、金融、法律等領域,我們需要 AI 的判斷是穩定且可預測的。你不會希望一個判斷腫瘤的 AI,今天看說是良性,明天看同一張片子卻說是惡性。
-
AI 訓練的穩定性: 論文還展示了一個例子。在「強化學習 (Reinforcement Learning)」這種 AI 訓練方法中,如果模型在「學習」和「實踐」這兩個階段的數值不一致,會導致訓練過程非常不穩定,甚至直接訓練失敗。而我們一旦實現了確定性推理後,AI 的學習過程效率和穩定性都大大提升。
所以,這篇論文的價值,不僅僅是解決了一個技術難題。它更深層的意義在於, 它代表了 AI 領域從一種「差不多就好」的狀態,向著更嚴謹、更可靠、更工程化的方向邁進 。
過去,當我們遇到數值上的微小差異時,很容易說:「沒關係,反正 AI 本來就是機率性的。」但這種「差不多先生」的心態,會阻礙我們建立真正值得信賴的 AI 系統。
Thinking Machines 的研究告訴我們,只要我們願意深入挖掘,去理解系統的每一個環節,那些看似隨機、無法解釋的「靈異現象」其實都有其物理和數學上的根源。而一旦理解了根源,我們就有能力去駕馭它、去改造它,最終建立一個真正可靠的智慧未來。
下一次,當你發現 AI 給了你不一樣的答案時,你將會知道,那可能不是因為它有了「新想法」,而只是因為在那一瞬間,有許多陌生人,悄悄地「跟你搭上了同一班車」。
延伸閱讀:Claude 3曾吐:我知道你在測試我!AI真有心智能力嗎?從「大海撈針」測試看起
行銷不必再靠感覺!調校AI讀懂人性、因果,還能識破經典啤酒尿布之謎